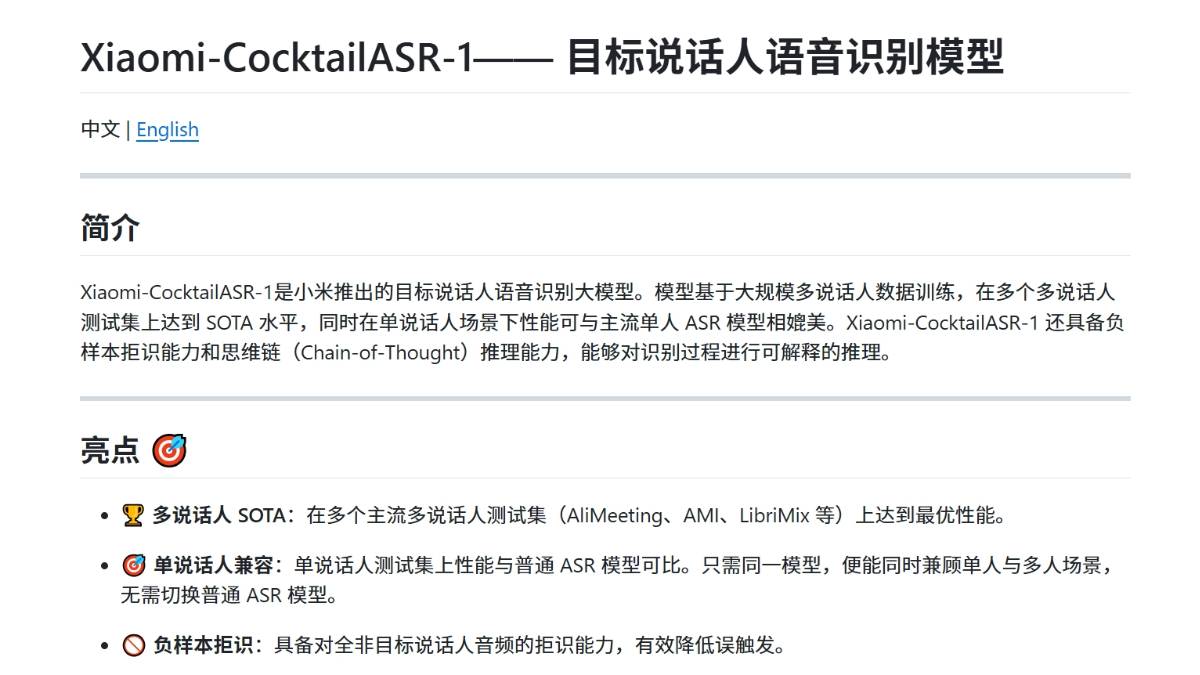
Xiaomi-CocktailASR-1 是小米推出的工业级目标说话人语音识别开源模型,专门处理语音领域经典的鸡尾酒会问题。模型采用端到端 LLM 架构,输入一段目标人物参考音频提取声纹特征,在多人重叠说话的混合录音里单独提取目标人声并完成文字转写。单人语音场景识别效果对标主流通用 ASR 模型,内置非目标人声拒识机制,搭配思维链推理输出识别逻辑。代码与权重基于 Apache2.0 协议开源,开发者可直接拉取部署,用于会议录音、采访音频等多人语音场景的开发调试。
Xiaomi-CocktailASR-1特点
采用目标声纹提示机制,不需要提前做语音分离步骤,直接完成指定说话人的语音转写。多人重叠语音测试数据集上取得领先指标,混合人声环境识别错误率大幅降低。
单人语音场景下保持稳定识别精度,同一套模型覆盖单人、多人混合两类音频输入。目标人物未出现在音频片段时,模型返回空文本,减少设备误触发情况。
内置思维链推理模式,识别结果附带推理过程,方便开发者定位识别错误来源。开源发布完整权重、推理代码,依赖库精简,在 HuggingFace 与 GitHub 提供资源下载。
支持单声道音频输入,参考音频与待识别音频拼接送入模型,适配各类录音设备采集的音频素材。
Xiaomi-CocktailASR-1技术原理
Xiaomi-CocktailASR-1 使用端到端 LLM 架构,核心由 D2V2 音频编码器、Adapter 模块与文本解码器构成。参考音频送入编码器提取声纹嵌入特征,混合音频同步提取声学特征,两类特征经过 Adapter 模块对齐融合。
融合后的特征送入 LLM 解码器,完成声学特征到文本 token 的映射。训练阶段使用大量单人、多人重叠语音数据,学习区分不同说话人声纹特征,建立目标人声与文本内容的对应关系。
拒识模块学习区分目标人声与干扰人声的特征分布,音频内不存在目标说话人时触发拒识逻辑。思维链分支在解码过程输出中间判断信息,还原模型识别的推理路径。
Xiaomi-CocktailASR-1项目地址
- GitHub仓库:https://github.com/xiaomi-research/xiaomi-cocktailasr-1
- HuggingFace模型库:https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
Xiaomi-CocktailASR-1功能
目标说话人转写
录入目标人物简短参考音频,对多人同时发言的混合录音,仅转录该目标人物的语音内容。
单人语音识别
处理单人清晰语音音频,输出文本转录结果,适配普通录音转文字需求。
非目标人声拒识
音频内没有目标说话人声音,模型直接返回空白输出,屏蔽无关人声带来的误识别。
思维链推理输出
开启对应模式,识别结果附带推理步骤,展示模型判定说话人身份、提取语音内容的过程。
模型本地部署
加载开源权重,在本地服务器、开发环境搭建语音识别服务,自主控制音频数据流转。
模型二次调优
导入行业场景音频数据集,做适配微调,优化特定口音、特定环境下的识别表现。
Xiaomi-CocktailASR-1应用场景
会议记录系统
多人开会录音,选定参会人作为目标说话人,单独提取该参会人的发言文本,区分重叠对话。
采访音频整理
多人访谈素材,依托采访对象的参考声纹,剥离其他人员插话,单独整理受访者发言。
智能硬件语音交互
搭载到智能设备,绑定使用者声纹,过滤环境内其他人说话声音,减少误唤醒与误识别。
音频内容审核项目
针对多人人声录音,定向提取指定人员发言内容,简化音频内容抽取流程。
语音算法科研实验
用于目标说话人识别、多人语音处理方向的算法研究,作为基线模型开展对比测试。
Xiaomi-CocktailASR-1同类产品对比
表格
| 对比维度 | Xiaomi-CocktailASR-1 | Qwen3-ASR |
|---|---|---|
| 研发主体 | 小米(Xiaomi) | 阿里通义千问(Qwen) |
| 产品定位 | 目标说话人 ASR,专门解决鸡尾酒会多人混声场景,给定声纹参考只转录指定人声 | 通用语音识别模型,支持多说话人转写,输出全员对话文本 |
| 核心特色 | 端到端 LLM 架构,声纹参考输入,支持非目标人声拒识,带思维链推理,Apache2.0 开源;多人重叠语音下提取目标说话人文字 | 通用场景识别强,自带说话人分轨,适合常规会议录音,不支持指定单一目标人声过滤 |
| 适用场景 | 多人同时发言、嘈杂环境,只提取特定人语音转写;设备语音防误触发 | 常规会议录音、播客、采访,需要输出全部多人对话文本 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...