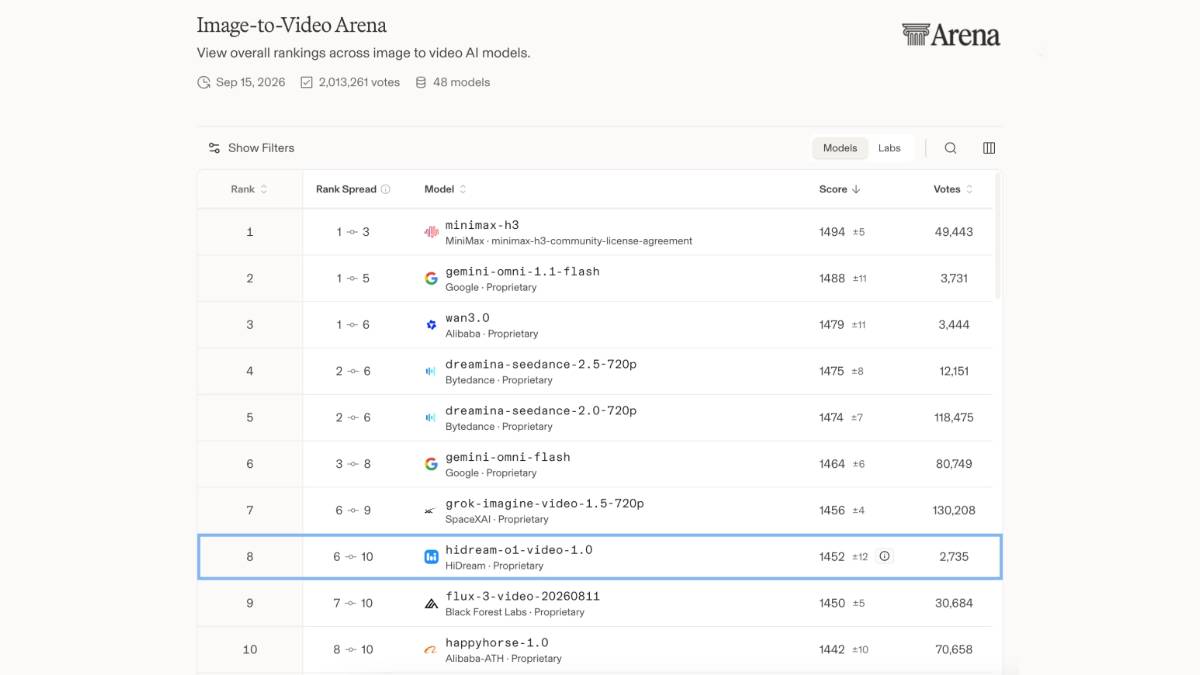
HiDream-O1-Video-1.0(简称 HD-V1)是智象未来 HiDream.ai 推出的原生全模态视频生成模型。依托自研 UiT 架构,支持文本、图片、视频多类型输入,输出 5 至 20 秒 1080P 高清视频。模型将画面、音频、文本联合建模,实现音画同步生成,强化对物理规则的理解,生成内容具备连贯叙事能力。可通过 API 调用,适配短视频、广告、影视分镜等内容生产,多项第三方评测榜单取得靠前排名。
HiDream-O1-Video-1.0特点
原生全模态联合建模,打破传统视频生成先出画面再后期配音的模式,画面与音频在同一生成流程同步产出。
强化物理因果建模,物体碰撞、重力、流体形变等动态效果更贴合现实规则,减少物体穿插、漂浮等常见生成缺陷。
支持多类输入方式,文本提示词、静态参考图、短参考视频均可作为生成条件,输出分辨率匹配原图比例。
视频时长可在 5 秒至 20 秒区间调整,画面维持 1080P 高清规格,人物口型、动作与音效节奏保持同步。
内置叙事规划模块,长片段生成维持场景、人物、道具的时空一致性,降低画面漂移、物体形态突变问题。
对外开放异步 API 接口,任务提交后通过任务 ID 获取生成结果,方便接入各类内容制作平台完成批量生产。
HiDream-O1-Video-1.0技术原理
HiDream-O1-Video-1.0 基于智象自研 UiT 原生全模态 Transformer 架构搭建。文本、图像、音频信号送入统一编码器,映射至共享表征空间,三类信号在生成阶段互相约束。
训练阶段引入大量物理仿真样本,学习刚体运动、流体、柔性物体形变等动态规律,建立物理因果的归纳偏置。
时序记忆模块存储场景几何、物体位置信息,生成连续帧时调取空间特征,维持跨帧的空间结构稳定。
推理阶段采用音画联合自回归生成,画面运动信息驱动音频生成,音频信息反向约束画面动作,实现口型、音效、动作同步对齐。
异步任务调度机制处理批量生成请求,拆分渲染任务,平衡算力负载,适配云端服务的并发调用场景。
HiDream-O1-Video-1.0功能
文生视频
输入文字描述,直接生成带配套音效、背景音乐的完整视频片段。
图生视频
上传一张静态参考图像,搭配提示词,让画面内物体与场景产生连续动态变化。
参考视频续画
导入简短参考视频,延续原有场景风格、人物特征,拓展更长的视频片段。
音画一体化生成
视频画面与音频同步生成,人物对白、环境音效、配乐随画面动作同步变化。
叙事镜头生成
接收分镜描述,生成带镜头推拉摇移的视频素材,维持叙事逻辑连贯。
API 批量生成
调用云端接口,批量提交视频任务,自动化产出多条短视频素材。
HiDream-O1-Video-1.0应用场景
短视频内容创作
自媒体、短视频创作者快速产出剧情短片、产品展示片段,配套原生音效素材。
商业广告制作
品牌营销短片、电商商品展示视频,快速迭代多版本广告素材,缩短制作周期。
影视前期预演
影视团队制作分镜动态预览,验证镜头语言、场景光影与人物动作效果。
游戏与动画前期开发
生成角色动作、场景动态参考片段,作为动画原画、游戏场景预演素材。
数字内容平台
接入内容平台,为用户提供 AI 视频生成能力,搭建视频创作工具。
AI 模型评测实验
用于视频生成领域的算法研究,开展物理一致性、时空连贯性相关基准测试。
HiDream-O1-Video-1.0同类产品对比
表格
| 对比项 | HiDream-O1-Video-1.0 | PixVerse R2 |
|---|---|---|
| 研发主体 | 智象未来 HiDream.ai | PixVerse |
| 产品定位 | 原生全模态视频生成模型,支持音画一体化输出 | 文生 / 图生视频生成模型,主打高动态画面 |
| 核心特色 | 自研 UiT 架构,内置物理规律约束,可自主规划叙事,原生音画同步生成,输出 5–20 秒 1080p 视频 | 动态镜头表现力强,支持长时序视频生成,画面光影细节优秀,适配短视频创作 |
| 适用场景 | 影视分镜、营销短视频、AI 内容叙事创作 | 短视频广告、创意短片、动态视觉素材制作 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...