科大讯飞正式发布语音基座大模型Spark-Audio-1.0-Preview。这是业界首个基于全国产化算力集群训练的语音基座大模型,采用0.65B稠密音频编码器搭配30B-A3B混合专家(MoE)语言模型,使用1300万小时音频及大量文本数据训练而成。该模型支持文本与语音双模态输入、文本输出,覆盖99种语言和202种方言识别,在Fleurs、KeSpeech、LibriSpeech等评测中得分高于Gemini-3.1 Pro,Fleurs中文测试集达到SOTA;目前已在讯飞星火官网开放免费体验,API服务后续将上线讯飞开放平台。
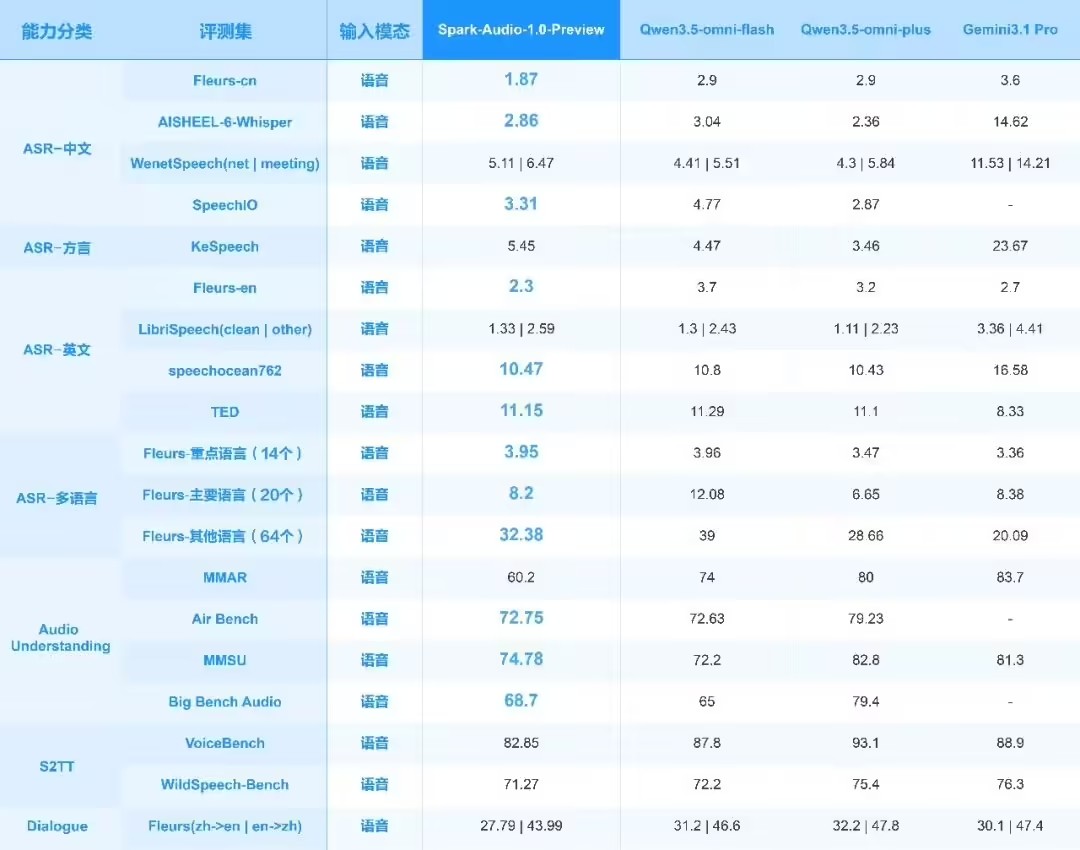
Spark-Audio-1.0-Preview特点
- 端到端直接理解语音:跳过“先转文字再理解”的级联链路,直接从音频中提取语义、情绪、场景信息,人声、环境音、音乐一次处理完毕。
- 全国产算力训练:从训练到推理全链路跑在国产算力集群上,为信创、政企等对算力自主可控有硬性要求的场景提供了现成选项。
- 小尺寸打出大模型效果:训练数据量仅为同尺寸Qwen3.5-omni-flash的十分之一,多语言、多方言识别效果反超,整体表现接近高一个数量级的Qwen3.5-omni-plus。
- 复杂场景抗干扰强:高噪声、小音量、远距离收音等真实工况下优势明显,这类偏应用类的任务表现优于公开测试集上的纸面成绩。
- 文本能力不降智:接入音频模态后,通用知识、数学、代码等纯文本任务没有出现明显退化,一套模型能同时兼顾对话与音频处理。
Spark-Audio-1.0-Preview技术原理
传统方案把语音识别、声纹、翻译、情感分析拆成独立模块串联,信息在环节间层层损耗。Spark-Audio-1.0-Preview走的是统一建模路线,具体分三步推进。
音频编码器预训练:先用大规模无标注音频做自监督预训练,把0.65B的Dense编码器喂足,让它在波形层面建立起对音素、韵律、音色、环境声的表征能力,再逐步扩展表征范围。这一步决定了模型能不能“听懂”语气和环境,而不只是“听清”字。
音视频-文本联合预训练:将音频编码器接上30B-A3B的MoE语言模型,用1300万小时音频对齐文本进行跨模态预训练。MoE结构保证每次推理只激活约3B参数,控制推理成本;音频token与文本token进入同一套注意力机制,语义、说话人、情绪在同一空间完成对齐。
多任务后训练:在转写、翻译、方言识别、环境音识别、说话人区分、情感分析、音频问答等任务上做指令微调与偏好优化,同时保留通用对话和推理能力。官方坦承当前版本在指令遵循、多轮对话、复杂音频理解上仍有追赶空间,后续会持续补齐。
Spark-Audio-1.0-Preview功能
- 语音转写:支持中英日韩法德西阿俄等99种语言及202种方言免切识别,语种混说自动判断,输出带智能标点和大小写。
- 多方言识别:市级方言全覆盖,粤语、闽南语、川渝话、东北话等均可直接输入,无需提前指定方言种类。
- 多语言翻译:音频直译文本,跳过中间转写环节,保留原句的语气强弱和停顿节奏。
- 环境音识别:分辨车流、风雨、机器运转、婴儿啼哭、玻璃破碎等背景声,并纳入场景判断。
- 说话人识别与分离:多人对话自动区分角色,输出带说话人标签的分段文本。
- 情感分析:识别愤怒、焦虑、犹豫、满意等情绪状态,可配合情绪强度做分级。
- 音频问答:针对整段录音提问,比如“客户在第几分钟提出价格异议”“会议最终定了哪三个结论”。
Spark-Audio-1.0-Preview应用场景
- 客服质检:全量录音自动过审,话术规范、服务态度、问题解决率一并出结构化报告,替代人工抽检。
- 会议纪要:多人讨论自动分角色、提取决策点和待办事项,直接生成可归档的结构化纪要。
- 医疗电子病历:问诊录音转写后抽取主诉、既往史、用药情况,减少医生手工录入。
- 汽车座舱与机器人交互:嘈杂环境下识别小声指令,结合情绪感知调整回应策略,让多轮对话更连贯。
- 实时同传与跨语言会议:保留说话人的语气韵律,译文不生硬,适合外事、商务谈判场合。
- 内容审核与舆情:同步判断说了什么、用什么情绪说、背景是什么环境,降低误判率。
- 涉外与方言地区服务:99语种加202方言免切,适合口岸、文旅、基层政务窗口这类口音混杂的场景。
Spark-Audio-1.0-Preview使用教程
网页端体验
- 打开讯飞星火官网,登录或注册账号。
- 在首页模型选择区域找到Spark-Audio-1.0-Preview,或在体验入口页(
xfyun.cn/experience/spark-audio)直接进入。 - 点击上传音频文件,支持常见格式如WAV、MP3、M4A、PCM,单文件时长建议控制在数分钟到一小时内以保证响应速度。
- 选择任务类型:转写、翻译、方言识别、情感分析、音频问答等,部分任务需额外填写目标语种或提问内容。
- 提交后等待结果,可在页面上查看分段文本、说话人标签、情绪标注,问答类任务会直接给出定位到时间点的回答。
- 体验结果支持复制导出,用于效果验证和内部比对。
接入准备(API尚未开放)
- 官方已明确API后续将上线讯飞开放平台,现阶段无法通过接口调用。有集成需求的团队可以先用网页端跑通效果验证,准备好典型音频样本和验收指标。
- 正式接入时大概率沿用讯飞开放平台现有的鉴权方式(AppID、APIKey、APISecret),计费口径可能按音频时长结算,具体以平台公告为准。
- 若已有业务跑在讯飞的实时语音听写、录音文件转写等旧接口上,迁移时要注意新旧模型的返回字段差异,特别是说话人标签和情绪字段属于新增能力,老解析逻辑需要补适配。
Spark-Audio-1.0-Preview同类产品对比
表格
| 项目 | Spark-Audio-1.0-Preview | Qwen3.5-omni-Flash |
|---|---|---|
| 研发主体 | 科大讯飞 | 阿里通义实验室 |
| 模型定位 | 全国产算力训练语音基座大模型,音频原生理解,支持音频问答、多语种多方言识别 | 多模态通用基座模型,集成音频、图像、文本能力,音频为其中一个模态 |
| 核心特色 | 0.65B 音频编码器 + 30B-A3B MoE 架构;99 种语言 + 202 种方言;高噪、小音量复杂音频表现突出,国产算力全链路训练 | 生态完善,音图文一体;部署工具链成熟,综合多模态能力均衡 |
| 适用场景 | 语音转写、声纹识别、音频情感分析、嘈杂环境语音交互、国产化业务落地 | 通用多模态问答、图文 + 音频混合任务、轻量多模态 Agent |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...