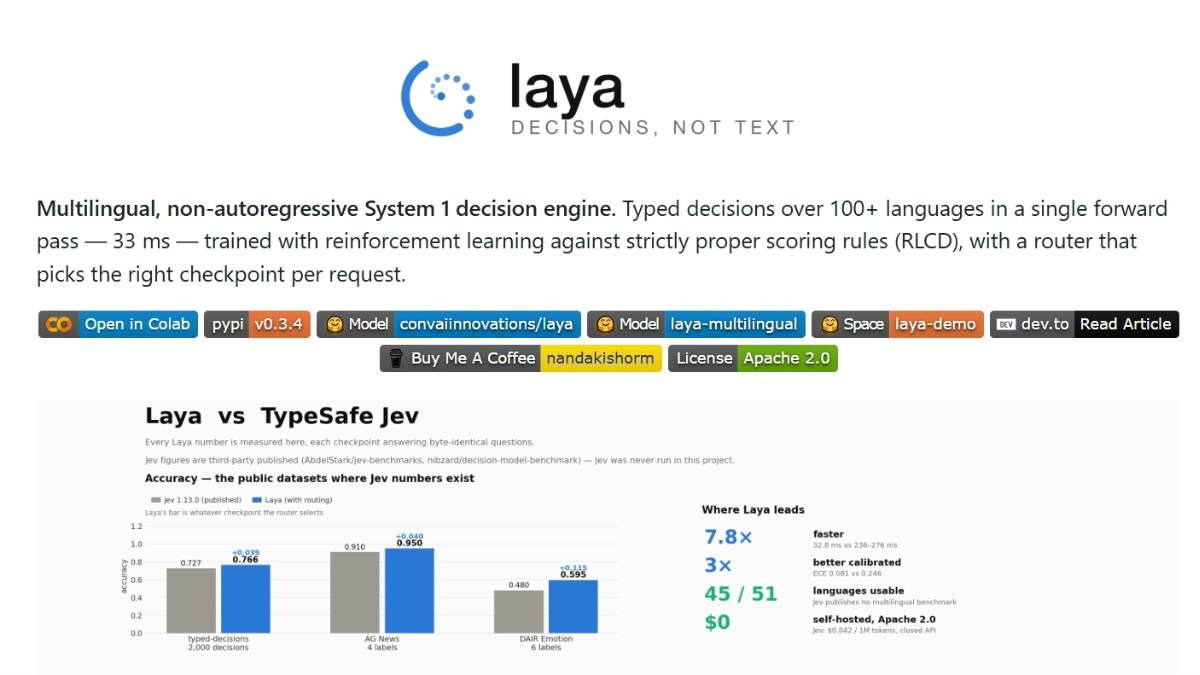
Laya 是一款开源决策模型,遵循 Apache 2.0 协议对外开放权重与完整工程代码,面向工单分流、意图路由、内容风控这类反射型决策任务设计。模型不输出自然语言文本,直接输出布尔结果、单选分类、量表概率等结构化数值,单次推理耗时约 33 毫秒,规避生成式大模型常见的幻觉、JSON 解析异常等问题。项目原生支持超过百种语言的处理调度,可直接部署在本地硬件运行,不需要依赖庞大的生成模型推理集群,为短周期判断任务提供轻量化推理方案。
Laya特点
输出形式限定为结构化数值,不会产出自由文本,从底层规避内容虚构问题。
推理开销低,单条请求处理耗时维持在毫秒区间,高并发请求下依旧保持稳定响应速度。
权重文件体积可控,适配本地设备部署,不需要高性能算力硬件。
内置多语言适配能力,不同语种输入可以走同一套推理逻辑。
输出概率经过校准,分类打分结果波动幅度小。
开源协议宽松,权重、源码均可自由修改复用,适配二次开发。
Laya技术原理
模型主干采用双向编码器网络结构,搭配强化学习完成任务调优,训练阶段围绕各类反射决策样本完成拟合收敛。
输入文本送入编码器完成语义向量编码,网络内部不执行文本解码生成流程,直接映射到对应输出空间,产出布尔值、分类标签、概率分数。
内部路由模块完成字符级快速调度,将输入分发至对应计算分支。
推理链路去掉 token 生成循环,计算只做前向传播,大幅压缩推理耗时。
输出层做概率校准处理,修正模型输出偏移,保证打分结果贴合真实业务分布。
Laya功能
接收文本输入输出布尔判断结果,完成二元类业务判断。
执行多类别分类任务,返回各个类别对应的概率数值。输出量表形式分级分数,完成内容等级评估。
支持批量文本并行推理,一次性处理多条输入样本。
提供本地推理接口,可供其他程序调用获取结构化输出。
开放权重文件,支持开发者基于自有数据集继续微调。
输出结果为标准化数值格式,便于程序直接读取解析。
Laya应用场景
业务系统内部工单自动分流,对工单内容完成类别划分。
内容平台内容风控环节,对文本做风险等级评估。
智能 Agent 内部意图路由模块,判断用户请求应当交给哪一个子模块处理。
企业内部业务过滤流水线,对大批量消息做筛选标记。
研究人员开展决策模型相关对照实验,搭建基准测试环境。
开发者搭建低延迟 AI 服务,替换高开销生成模型完成简单判断任务。
Laya如何使用
访问项目 GitHub 仓库,克隆完整代码仓库到本地开发环境。
准备对应版本 Python 运行环境,安装项目依赖库。
下载项目发布的模型权重文件,放置到指定权重目录。
编写调用代码加载模型,传入待处理文本样本,调用推理接口获取分类、概率等结构化返回数据。
使用自有业务数据集执行微调流程,调整模型适配业务专属样本。
封装推理接口,对外提供 HTTP 调用服务,接入业务系统。
采集线上真实样本,持续校验输出概率校准效果,按需更新权重。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...