
Qwen-Audio-3.1 是阿里通义千问推出的音频多模态模型系列,一次性发布五款子模型,覆盖语音识别、语音合成、实时语音交互、音频创作全链路能力。整套体系包含 ASR、TTS、Realtime 实时语音交互分支,支持多语种、方言、重叠人声处理,长音频场景自带转写润色能力。模型在音频理解与语音生成层面完成升级,配套调用成本大幅下调,兼顾低延迟交互与长音频批量处理,面向开发者提供完整音频技术栈,适配各类语音产品的开发与落地。
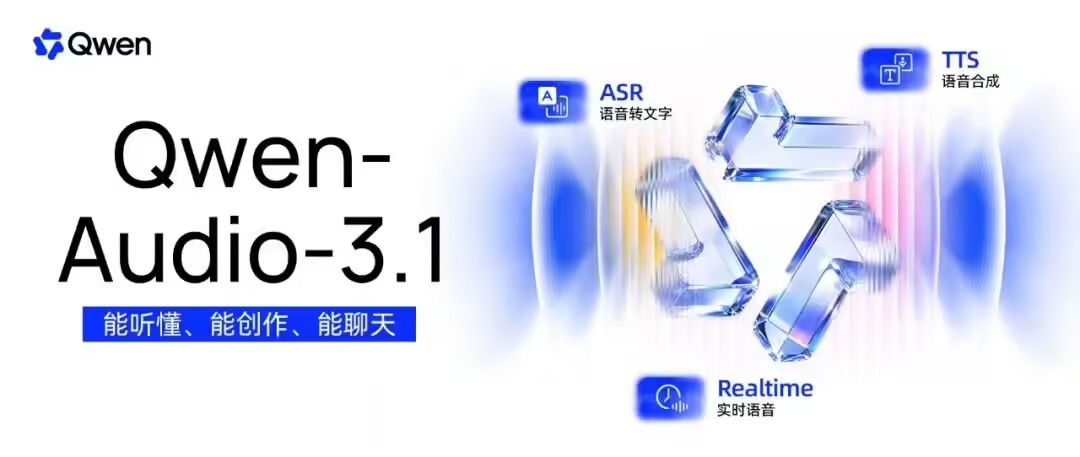
Qwen-Audio-3.1特点
采用端到端一体化音频处理架构,语音识别、语音合成、实时对话能力整合在统一模型体系。
支持 30 种语言与 16 类中文方言,嘈杂环境下人声识别稳定性强。
长音频转写自动剔除语气助词、重复语句,输出通顺文本,附带说话人标记与时间戳。
实时语音交互支持全双工对话,智能判断对话停顿,不会被无意义杂音打断。
音色资源丰富,可自定义声线风格,生成语音自然流畅。云端调用资费下调,适合大规模业务并发请求。
Qwen-Audio-3.1技术原理
基于 Qwen 大模型主干架构,增加音频编码器完成声学信号向语义向量的转换。
预训练数据集收录海量多语种音频、方言录音、会议对话、有声读物素材,学习声学特征与文本之间的映射关系。
ASR 分支采用流式声学建模,逐帧解析音频流,同步完成说话人区分。
TTS 分支使用声码器重构音频波形,优化韵律、停顿与重音表达。
Realtime 实时模块依托 WebSocket 事件驱动机制,持续收发音频流,搭配多教师蒸馏策略优化对话行为,实现边听边响应。
Qwen-Audio-3.1功能
语音识别,处理录音、会议音频,输出带时间戳、角色区分的转写文本,自动润色文稿。
语音合成,将文字转为自然人声,切换多语种、方言音色,生成旁白、播报音频。
实时全双工语音对话,接收麦克风音频输入,即时返回语音应答,支持工具调用。
音频内容解析,读取音频文件,提取对话信息,总结音频核心内容。
批量音频处理,批量上传录音文件,完成转写、分类、内容摘要。
自定义音色,基于参考样本生成专属声线,适配品牌语音需求。
Qwen-Audio-3.1应用场景
线上语音客服系统,接收用户语音提问,完成实时应答。
会议记录平台,录制会议音频,生成带发言人标记的会议纪要。
有声内容制作,批量生成有声书、短视频旁白、广播配音。
教育类语音产品,语音听写、口语测评、外语听力练习。
车载语音交互,完成车内连续语音指令接收与反馈。
媒体采编,处理访谈录音,快速提取采访文字素材。
Qwen-Audio-3.1如何使用
访问阿里云 Model Studio 平台,注册账号并开通模型调用权限,获取 API 密钥。
API 调用时选择对应子模型标识,ASR 处理长音频文件可上传音频资源包,开启角色分轨与文本润色参数。
TTS 接口传入文本内容,指定 voice 音色 ID,设置语速、音调参数,返回音频流。
实时语音交互使用 WebSocket 协议建立会话,持续推送麦克风采集的音频片段,接收文本与音频返回结果。
本地测试阶段使用平台在线调试页面,上传音频样本验证识别与合成效果。
业务开发阶段配置音频预处理逻辑,对原始音频做降噪处理。
大规模上线前,准备方言、嘈杂环境样本开展测试,调整采样参数。
业务系统增加音频文件存储与结果校验模块,留存转写记录。
Qwen-Audio-3.1同类产品对比
表格
| 项目 | Qwen-Audio-3.1 | StepAudio 3 |
|---|---|---|
| 研发主体 | 阿里通义千问 | 阶跃星辰 |
| 产品定位 | 一站式音频大模型,覆盖 ASR、TTS、实时双工语音交互、音频事件理解 | 多模态音频大模型,主打语音对话、音频理解、音色生成 |
| 核心特色 | 完整音频能力栈,支持 30 种语言 + 16 种中文方言,ASR 自带转写润色与分角色标注;TTS 可生成带环境音效的完整音频剧本;实时双工对话,API 定价大幅下调 | 音质表现力强,多语种语音识别、情感 TTS、音频内容问答能力突出,支持长音频理解,适合端侧与云端部署 |
| 适用场景 | 会议录音转写、有声内容创作、实时语音助手、硬件语音交互、音频事件分析 | 语音聊天机器人、播客 / 短视频配音、长音频内容解析、多语种语音交互产品 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...