
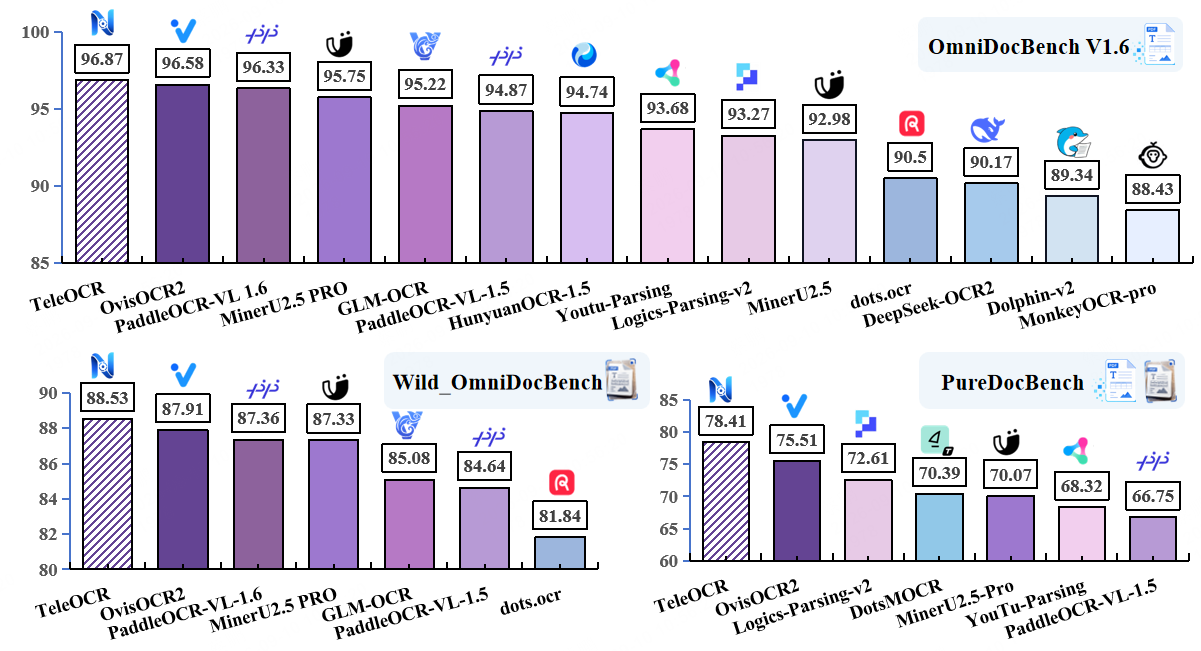
TeleOCR 是中国电信星辰实验室推出的开源文档解析视觉模型,总参数量约 1.2B,原生集成文档畸变矫正能力,无需额外预处理模块,直接处理拍摄形变文档、扫描件与电子 PDF 页面。模型在 OmniDocBench、PureDocBench 榜单取得靠前成绩,在 ICDAR 2026 科学图表解析竞赛拿到冠军,对表格、公式、科研图表的识别表现突出。普通消费级显卡即可完成本地推理,代码与权重全部开放,适合开发者搭建轻量化文档识别服务,处理各类存在褶皱、弯曲、倾斜的实拍文档图片。
TeleOCR特点
内置几何畸变自适应处理逻辑,应对纸张弯曲、折痕、拍摄倾斜带来的画面形变。
采用版面分割方案替代传统矩形框检测,适配不规则文档版面。
参数量控制在较低水平,硬件门槛不高,普通 GPU 即可加载运行。
科学类文档识别能力突出,可提取复杂公式、图表内的数值与文本信息。
输出支持多种结构化格式,保留文档原有排版逻辑。
项目完整开源,权重、推理代码、评测脚本对外公开,可二次修改。
TeleOCR技术原理
基于 Qwen2.5-VL 高分辨率视觉编码器,搭配 Qwen3-0.6B 轻量解码器构建模型主体。
视觉编码阶段对图像做自适应采样,形变明显区域提升采样点密度,平整区域降低采样开销。
训练数据集包含大量实拍文档、弯曲纸张、学术论文、扫描档案,学习形变图像、版面布局、公式图表之间的视觉特征映射。
推理阶段同步完成版面分割、文字识别、表格解析、图表信息提取,多任务在单次前向推理内完成。
TeleOCR项目地址
- GitHub仓库:https://github.com/caipeng328/TeleOCR
- HuggingFace模型库:https://www.modelscope.cn/models/XingChen-AGI/TeleOCR
TeleOCR功能
印刷体文字识别,读取实拍照片、扫描件、电子文档中的文本内容。
版面结构还原,识别标题、段落、表格区块,保留文档原始排版。表格提取,把图片内表格转为结构化文本,还原行列关系。
公式识别,提取科研文档里的数学公式,输出可复用的公式标记。
图表解析,读取各类科研图表,提取坐标轴、图例与数据点信息。
批量文档处理,批量上传图片文件,一次性输出解析结果。
TeleOCR应用场景
档案数字化项目,把老旧纸质档案拍照后批量转成结构化电子文档。
科研文献处理,提取论文中的文字、表格、公式,用于文献整理。
企业票据与合同电子化,识别拍摄后的合同、单据图片,提取关键内容。
图书馆资料数字化,处理存在褶皱、反光的古籍、期刊扫描照片。
开发者构建私有化文档解析服务,部署在内网环境处理涉密文档。
教育平台处理试卷、习题图片,提取题目文本与图表数据。
TeleOCR如何使用
前往 TeleOCR 开源项目仓库,下载模型权重与项目代码,配置 Python 运行环境,安装项目依赖包。准备待处理图片,支持 jpg、png 等常见图像格式,直接传入推理脚本。
单张图片测试,运行推理脚本,传入图片路径,模型输出识别文本、版面信息、表格与公式内容。批量任务编写简单脚本循环读取图片目录,批量执行解析并保存结果文件。
本地部署可搭配 vLLM 加速推理,提升图片处理速度。二次开发可基于项目代码修改后处理逻辑,自定义输出格式。
业务落地阶段,收集项目场景内的样本做测试,针对特定文档类型调整图像输入分辨率。内网部署场景,可脱离公网完成全部文档解析,保障资料安全。
TeleOCR同类产品对比
表格
| 项目 | TeleOCR | MinerU2.5 |
|---|---|---|
| 研发主体 | 开源社区 | 北大相关团队 |
| 产品定位 | 轻量文档解析 VLM 模型,主打畸变拍摄文档 OCR | 开源文档智能解析模型,PDF / 图片文档提取 |
| 核心特色 | 1.2B 小参数量,内置文档去畸变能力,自适应采样处理弯曲、褶皱文档,开源权重,版面分割能力强 | 支持 PDF 解析、公式与表格提取,多模态文档理解,对标准印刷文档效果优秀 |
| 适用场景 | 手机拍摄畸变文档、褶皱纸质材料、科学文献图片 OCR,本地轻量化部署 | 电子书、扫描 PDF、标准印刷文档批量解析,学术论文提取 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...