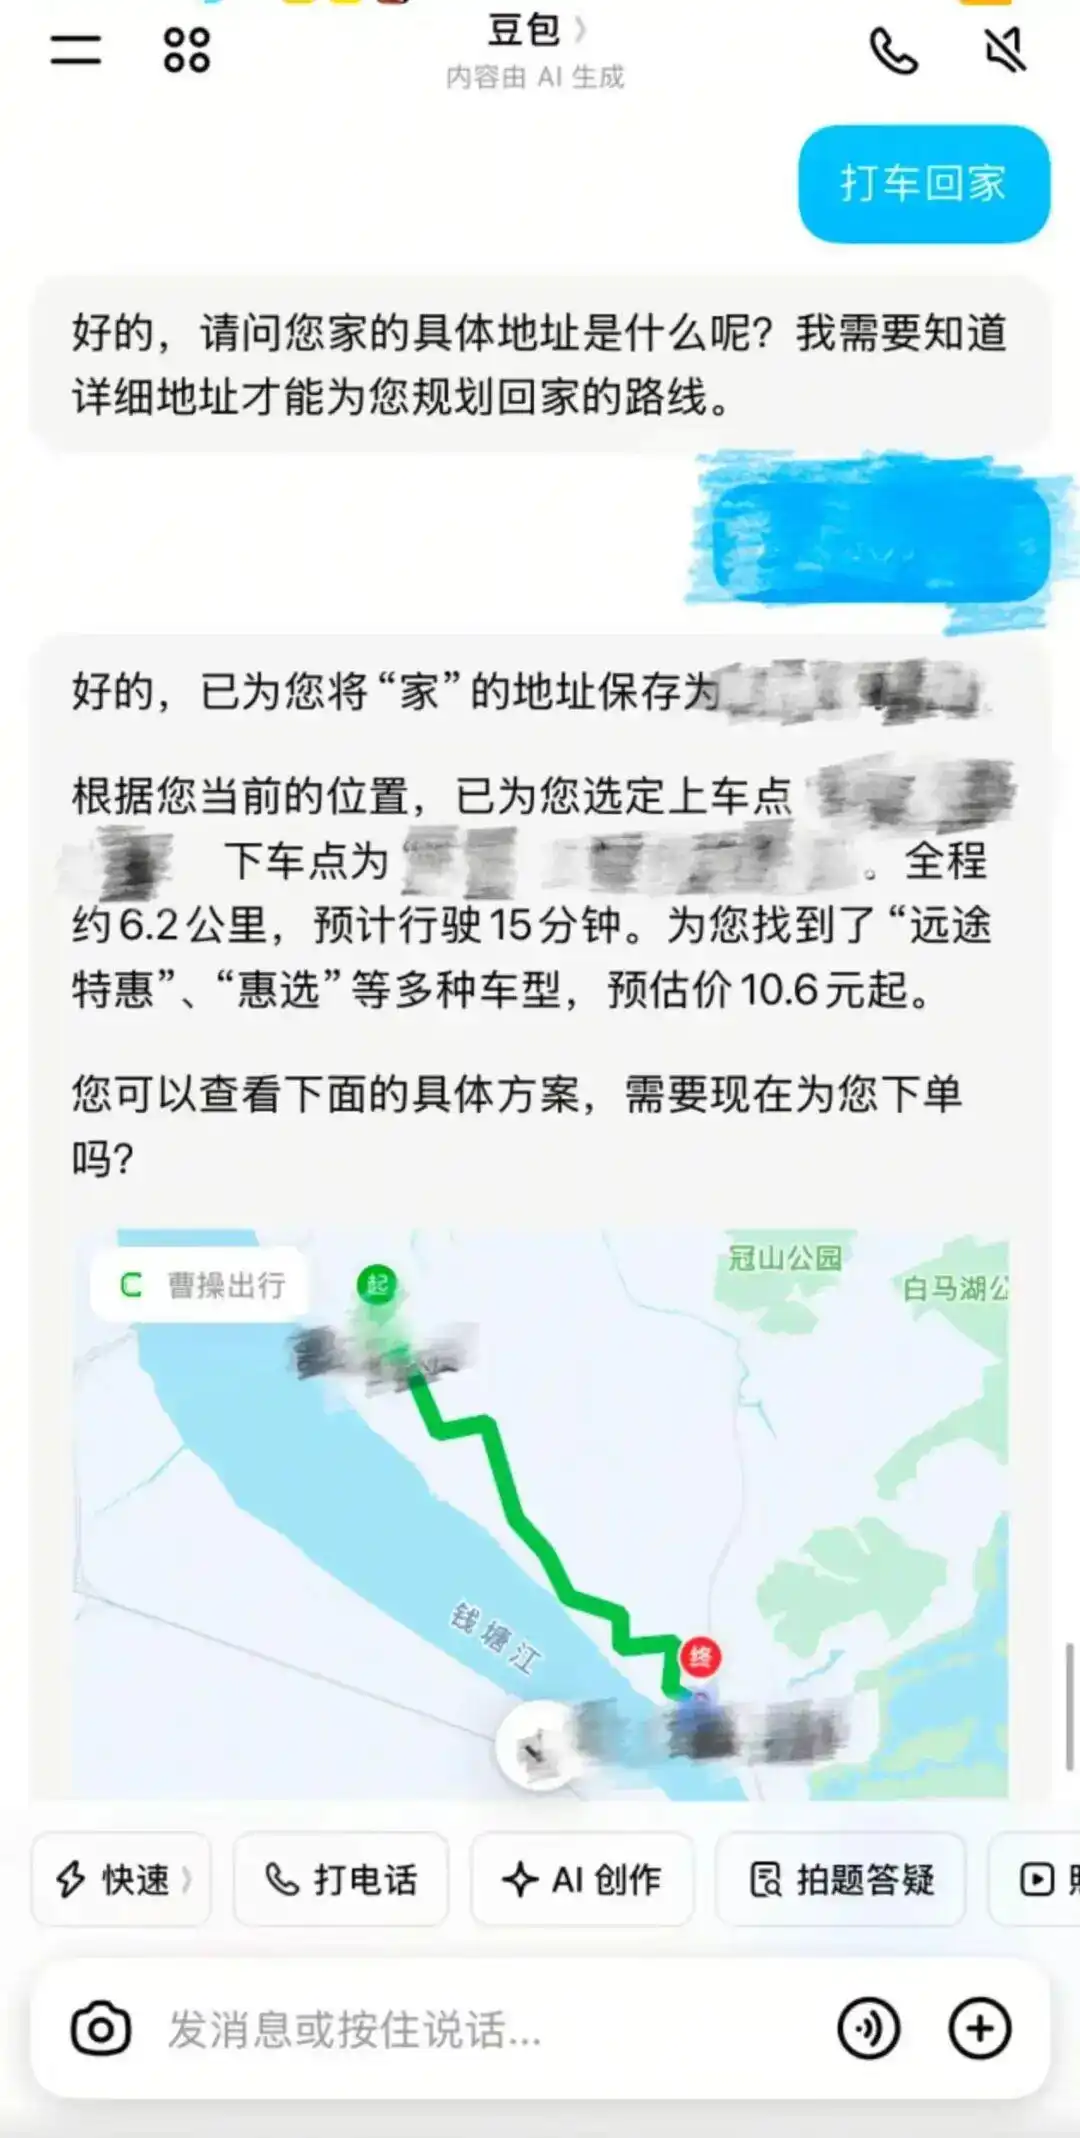
alkLikeYou是面向音频驱动数字人头部视频生成的开源研究框架,重点复刻人物独有的说话习惯,捕捉发音过程中细微唇部动作差异。现有数字人生成方案大多输出同质化面部运动,忽略个体细微口型特征,该框架在运动空间完成说话习惯建模,推理阶段仅需单步采样实现实时生成效果。支持参考视频提取目标人物说话风格,也可选用数据集内置预设风格,配套PLAD评估指标量化模仿相似度,开源代码、演示示例全部对外公开,可供研究人员与开发者二次调试。
alkLikeYou特点
可捕捉个体细微面部运动习惯,复刻不同人物独有的唇部、面部微动作。
推理链路做轻量化处理,单步采样完成画面生成,满足流式实时输出需求。
两种风格输入路径,上传参考视频提取说话习惯,或直接调用数据集内置预设风格。
提供 PLAD 专项评估指标,量化面部动作模仿相似度与生成结果多样性。
兼容写实人像与风格化肖像图片输入,输出画面保持人物身份特征稳定。
开源完整项目代码,可本地部署复现全部实验效果。
alkLikeYou技术原理
整体框架分为运动提取、运动生成、形变模块与解码器四大模块。输入源图提取首帧面部运动特征,音频送入音频编码器生成音频特征,Flow Matching 运动生成器完成习惯感知运动序列输出,该生成器依托统一习惯空间存储各类人物面部运动模式。训练采用两阶段模仿学习策略,第一阶段依托小数据集完成习惯编码重建,第二阶段使用大规模视频数据集提升泛化表现。生成的运动序列送入形变模块对齐源图身份信息,交由解码器渲染输出最终数字人视频。
TalkLikeYou项目地址
- 项目官网:https://bq-wang0511.github.io/TalkLikeYou/
- GitHub仓库:https://github.com/BQ-Wang0511/TalkLikeYou
alkLikeYou功能
音频驱动数字人头部视频生成,输入人像图片与音频输出同步口型视频。
从参考视频提取人物说话习惯,迁移至目标人像完成风格复刻。
调用数据集内置预设说话风格,直接套用不同人物面部运动模式。
PLAD 指标测算,评估生成视频的面部动作模仿精度与多样性。
支持风格化肖像输入,为动漫、插画类头像生成匹配音频的说话视频。
流式实时推理,输出可对接流媒体相关开发项目。
alkLikeYou应用场景
数字人内容制作,复刻真人细微说话神态,产出更具辨识度的播报视频。
虚拟主播研发,把真人说话动作习惯迁移到虚拟形象,弱化机械感。
学术研究,用于音频驱动人脸动画方向的算法对比与实验验证。
短视频素材生产,静态图片配合音频生成口播类数字人片段。
算法基准测试,使用 PLAD 指标衡量其他数字人生成模型的模仿效果。
alkLikeYou使用教程
1. 访问项目网页,查阅论文介绍与在线演示样例。
2. 前往 Hugging Face 或代码仓库下载项目源码与模型权重,准备 GPU 运行环境。
3. 配置项目依赖,完成环境编译,核对音频、图片、视频输入路径。
4. 准备源人像图片,选择风格来源,上传参考习惯视频或选取内置预设风格。
5. 输入驱动音频文件,启动推理脚本,得到习惯感知的数字人输出视频。
6. 调用 PLAD 评估脚本,对生成结果开展量化测算,调整参数迭代输出效果。
7. 面向开发场景,改造推理链路,对接流媒体接口实现流式实时输出。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...