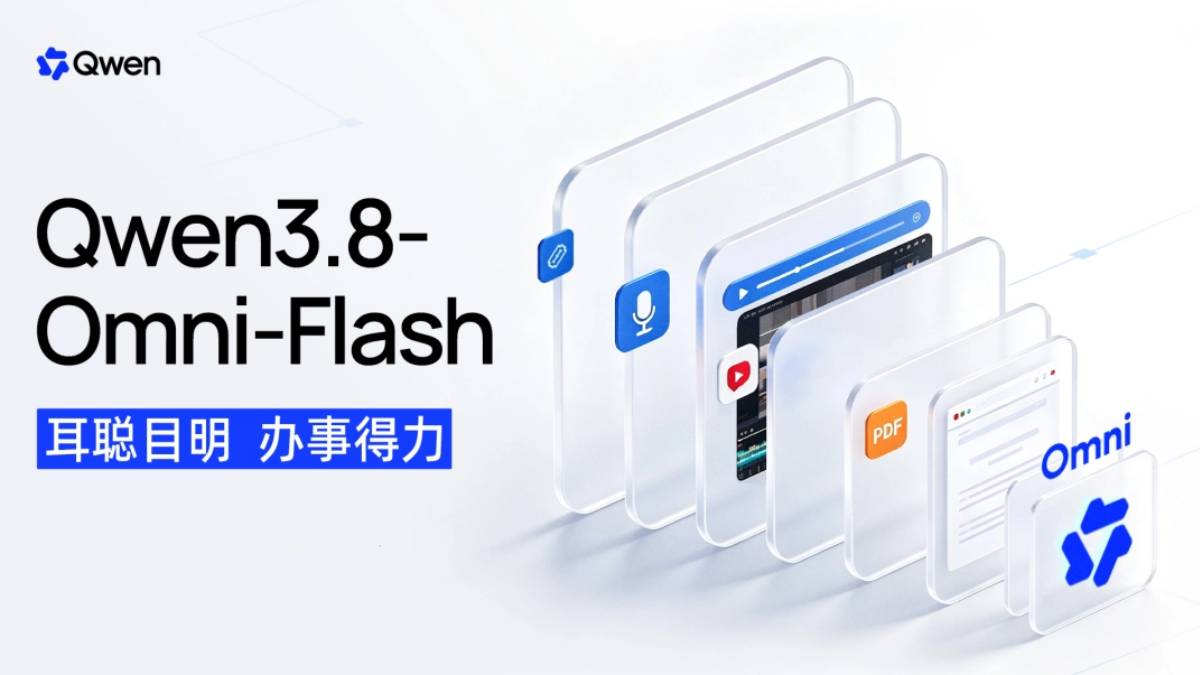
Beam 是 Reflection 发布的首款开放权重大模型,采用稀疏 MoE 专家架构,总参数量 501B,单 token 仅激活 23B 参数,采用 Apache2.0 许可协议对外放出权重。模型面向代码、复杂推理与智能体工作负载开发,预训练使用 23.8 万亿高质量多领域 token,搭配大规模强化学习流程,支持 1M 上下文窗口。在多项代码、STEM、工具调用基准拿到不错得分,推理阶段算力开销得到控制,企业部署时可以降低 token 生成成本,配套完整技术文档、评测套件,供开发者做二次调试与落地。
Beam特点
稀疏 MoE 专家架构,全部参数常驻权重存储,推理只调用对应激活专家,平衡知识容量与计算开销。
支持 1M 上下文窗口,可读取长代码库、长篇技术文档完成任务处理。
经过大规模异步强化学习训练,具备多步工具调用、终端操作、代码仓库修复能力。
内置可控推理长度调节参数,用户可调整推理 token 消耗,适配不同算力预算。
专家负载均衡优化,训练阶段各专家模块利用率接近均匀,减少部分模块闲置。
Apache2.0 开放权重协议,开发者可下载权重完成微调、私有化部署。
Beam优势
同等推理任务下对比同级别大模型,推理算力消耗缩减三至四倍,降低线上服务成本。
强化学习带来跨领域迁移能力,训练未覆盖的任务场景也可以输出可用方案。
训练链路经过稳定性优化,长 rollout 样本也可以维持学习效果,不会出现性能退化。
配套完整评测沙箱,可复现官方给出的代码、推理、智能体类基准测试结果。
预训练阶段完成大量代码、科学类数据清洗,对软件工程、STEM 类任务适配度高。
Beam项目地址
- 项目官网:https://reflection.ai/blog/introducing-beam
Beam功能
代码仓库级修复,读取完整项目代码,定位并修复程序缺陷。
终端智能体执行,下发系统指令,完成文件处理、环境部署、脚本运行。
高难度数理科学推理,处理竞赛数学、科研计算、复杂逻辑推导题目。
工具调用与网页浏览,对接外部工具接口,检索网页资料完成综合任务。
长文档解析,读取百万 token 级别的代码库、技术报告做问答与信息提取。
可控推理输出,调节推理努力参数,兼顾响应速度与难题解题成功率。
安全对齐推理,遵循安全策略,减少幻觉输出,适配生产环境调用。
Beam应用场景
企业代码智能体研发,搭建自动化程序调试、仓库重构、脚本生成服务。
科研机构算法实验,开展 MoE 大模型、强化学习智能体方向对照研究。
私有化部署推理服务,企业内网搭建代码助手、文档解析业务。
复杂工具链智能体开发,串联检索、计算、脚本执行,搭建自动化工作流。
开源大模型评测,在 SWE‑Bench、Terminal‑Bench 等基准开展模型性能比对。
STEM 领域辅助,完成数理推导、科研代码编写、技术资料梳理。
Beam使用教程
1. 访问 reflection.ai/blog/introducing‑beam 博客页面,查阅技术报告与模型发布说明,提交等待列表获取早期访问资格。
2. 权重正式发布后,下载完整模型权重,准备具备大显存 GPU 的推理硬件环境。
3. 部署推理运行框架,加载 Beam 权重,设置上下文窗口大小与推理努力参数。
4. 输入任务指令,代码修复、终端任务或者科学推理类需求,提交给推理引擎。
5. 开展工具调用类任务,对接沙箱环境,配置外部工具接口权限。
6. 运行官方配套评测脚本,在各类公开基准上测算模型实际表现。
7. 根据业务数据集开展微调,完成适配自身业务场景的二次迭代。
Beam同类产品对比
表格
| 产品 | 研发主体 | 产品定位 | 核心特色 | 适用场景 |
|---|---|---|---|---|
| Beam | Reflection AI | 稀疏激活开源大模型,主打代码与智能体任务 | 501B 总参数,仅激活 23B,推理成本低,代码与 STEM 推理能力突出,支持本地私有化部署 | 代码开发、Agent 复杂任务、高并发推理场景 |
| GLM-5.2 | 智谱 AI | 通用多模态稀疏大模型 | 超大总参,长文本理解优秀,综合推理强,完善 API 与开源权重,生态成熟 | 通用业务、文档分析、代码、企业私有化落地 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...