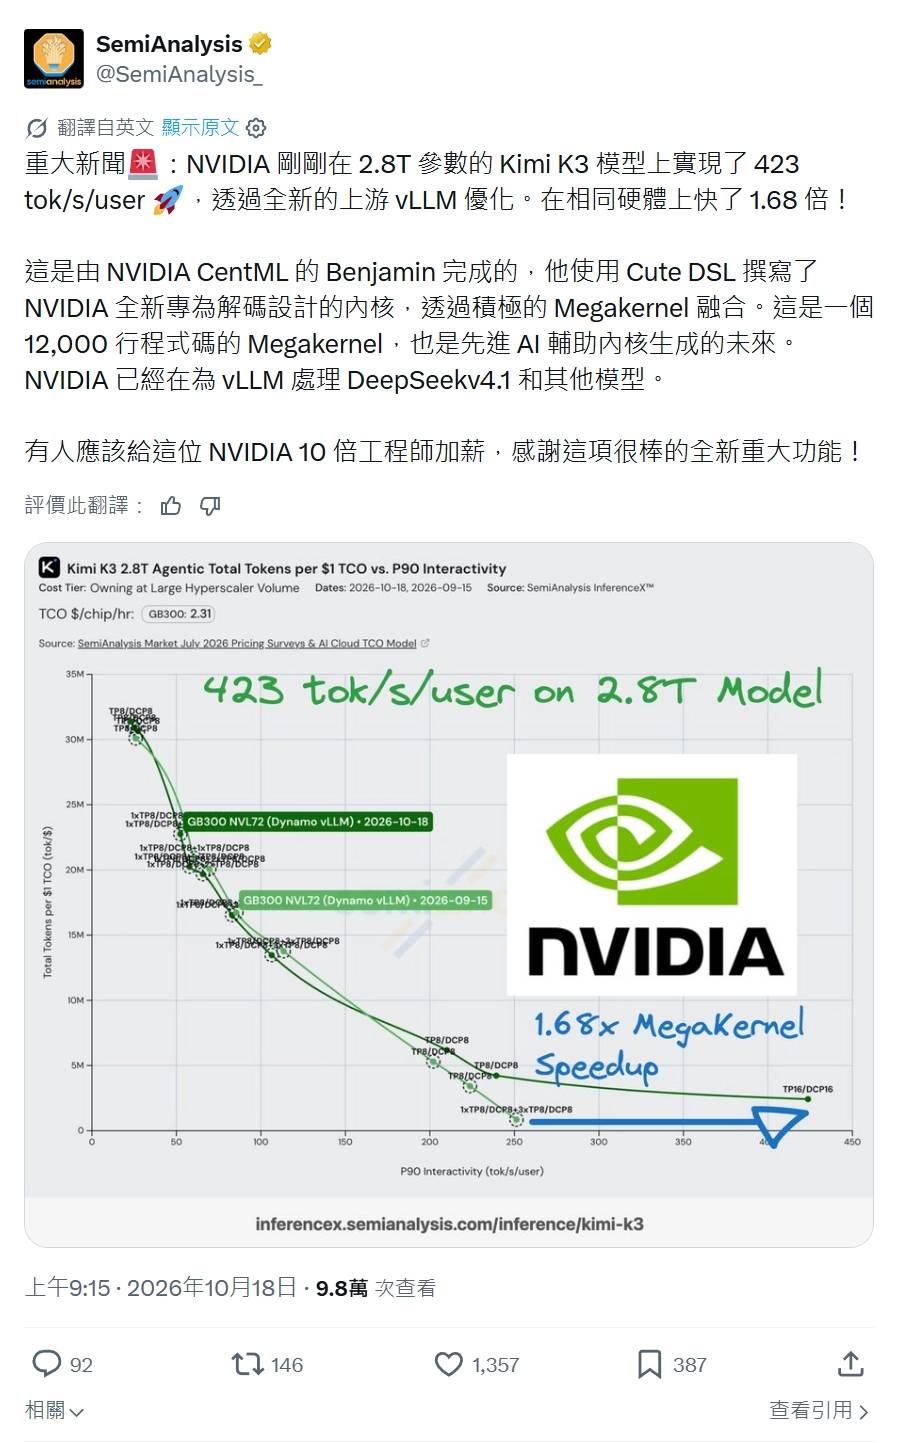
英伟达联合 vLLM 完成 Kimi K3 模型的推理层专项调优,在 GB300 NVL72 硬件环境中,单用户推理速度达到 423 tok/s,相比未优化版本提升 1.68 倍。
本次调优由 CentML 团队工程师主导,基于 CuTe DSL 编写 Megakernel 解码内核,整套内核代码规模达到 1.2 万行。整套方案对模型注意力模块、MoE 专家路由与跨卡通信链路做算子融合,削减计算间隙带来的资源损耗,适配 Kimi K3 超大参数量架构特性。
Kimi K3 为月之暗面推出的 2.8 万亿参数 MoE 模型,激活参数规模 104B,原生支持百万 Token 上下文窗口与多模态输入。大规模 MoE 架构在多卡集群部署时,跨节点数据交换会产生大量开销,直接拉高推理延迟。
这套优化方案面向 vLLM 推理引擎,限定在指定硬件拓扑与负载场景生效。同硬件条件下,长文本、智能 Agent 类任务的交互响应出现明显变化。英伟达同步推进 vLLM 对多款主流大模型的内核适配工作,覆盖 DeepSeek 等其他模型系列。
本次提速只针对推理运行时,模型本身权重与基础能力不会改动。生产环境部署需要配套对应版本 vLLM 与硬件集群,普通终端用户无法直接感知该变化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...