UnlimitedOCR2 是百度文心发布的开源端到端超长文档解析模型,依托 SR‑SWA 稀疏参考滑动窗口注意力搭配无限视域解码机制,摆脱传统 OCR 的页数限制,单次推理可处理数千页扫描文档。模型总参数量 3.34B,MIT 开源协议,代码、权重托管在 GitHub 与 HuggingFace 平台。支持印刷扫描件、卷宗、财报、教材公式等复杂版式,原生处理跨页表格与跨页段落,直接输出 Markdown 与 JSON 结构化内容。推理阶段显存不会随文档页数上涨,消费级显卡即可运行,同时提供云端 API,兼顾本地私有化与线上调用场景。
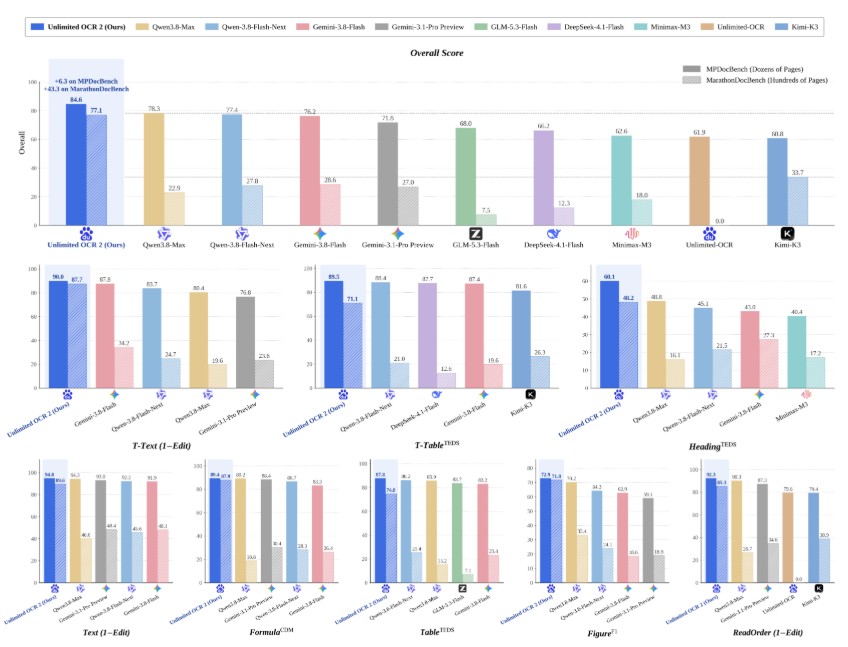
Unlimited OCR 2特点
SR‑SWA 稀疏参考滑动窗口注意力,搭配无限视域解码,显存开销维持稳定,页数增加不会造成算力暴涨。
端到端完整链路,不用分页切割再做后处理拼接,原生完成跨页表格、跨页段落合并。
兼容扫描书籍、档案卷宗、带公式教材、多栏财报等复杂版式,自动识别标题层级。
3.34B 混合专家架构,16bit 精度 8GB 显存可运行,量化版本进一步降低硬件门槛。
输出 Markdown 排版文本与带版面坐标的 JSON 数据,适配下游检索、知识库业务。
MIT 开源许可,本地部署无额外限制,同步开放云端 API,适配科研、企业业务两类场景。
Unlimited OCR 2技术原理
整体分为图像编码器与 MoE 混合专家解码器两大模块。
图像编码器把每页文档图像压缩为固定数量视觉参考 token,全部视觉 token 持续驻留内存。解码器全部替换 SR‑SWA 稀疏参考滑动窗口注意力,拆分为静态参考上下文与动态滑动窗口两部分。
静态参考上下文读取全部页面视觉 token,保障全文档图像信息可用;
动态滑动窗口仅保留近期输出 token,淘汰老旧输出 token,把每一步解码计算量控制在固定区间,页数扩张不会抬升计算复杂度。
后训练使用海量多页长文档样本,学习表格、公式、标题层级、跨页排版规则。
Unlimited OCR 2项目地址
- GitHub仓库:https://github.com/baidu/Unlimited-OCR
Unlimited OCR 2功能
大批量扫描文档一次性完成文本提取。 识别标题层级、段落、图表区块、数学公式,自动合并跨页表格与跨页段落。
输出保留排版格式的 Markdown,也可输出携带坐标、版面类型的 JSON 结构化数据。
批量图片输入,批量解析档案、书籍、财报卷宗。 对外提供推理接口,可供上层业务系统对接调用。
支持导入自有行业数据集,完成二次微调产出领域专属版本。
Unlimited OCR 2应用场景
图书馆、档案馆纸质资料数字化,将整本扫描书籍转为结构化电子文档。
金融机构解析数百页财报、招股文件,提取表格文本用于数据分析。
政务、律所处理卷宗扫描件,完成档案归档与检索前置处理。
科研机构解析教材、论文合订本,提取公式、图表构建知识库素材。
企业内部扫描合同批量解析,完成文档结构化入库。
算法研究领域开展超长文档 OCR、新型注意力机制对照实验。
Unlimited OCR 2如何使用
访问百度 GitHub 项目仓库,克隆 Unlimited‑OCR 项目代码,前往 HuggingFace 下载 Unlimited‑OCR2 预训练权重。
搭建 Python 运行环境,安装 transformers、图像处理、推理加速相关依赖包,确认显卡显存达到最低运行标准。 修改配置文件,填写权重存放路径,选定输出格式为 Markdown 或者 JSON。
传入单张或者批量文档图片,发起推理,等待解析完成获取结果文件。
硬件显存不足时加载 INT4、INT8 量化权重,降低资源占用。
线上业务开发可调用官方开放 API,获取访问密钥,提交图片请求直接拿到结构化返回。
垂直业务准备行业文档数据集,使用仓库内置微调脚本训练,导出适配业务的权重投入生产流程。
Unlimited OCR 2同类产品对比
表格
| 项目 | 开发方 | 产品类型 | 核心亮点 | 适用场景 |
|---|---|---|---|---|
| Unlimited OCR 2 | 百度文心 | 开源超长文档解析 OCR 模型 | SR-SWA 稀疏注意力,支持无限页数一次性解析,KV 显存大幅降低,跨页表格、长文档连贯性强,本地可部署 | 书籍、百页 PDF、长篇报告批量解析 |
| DeepSeek-OCR | 深度求索 | 开源文档 OCR 模型 | 版面还原出色,表格、公式识别表现优秀,输出 Markdown 结构化结果 | 常规多页文档、论文、技术资料解析 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...