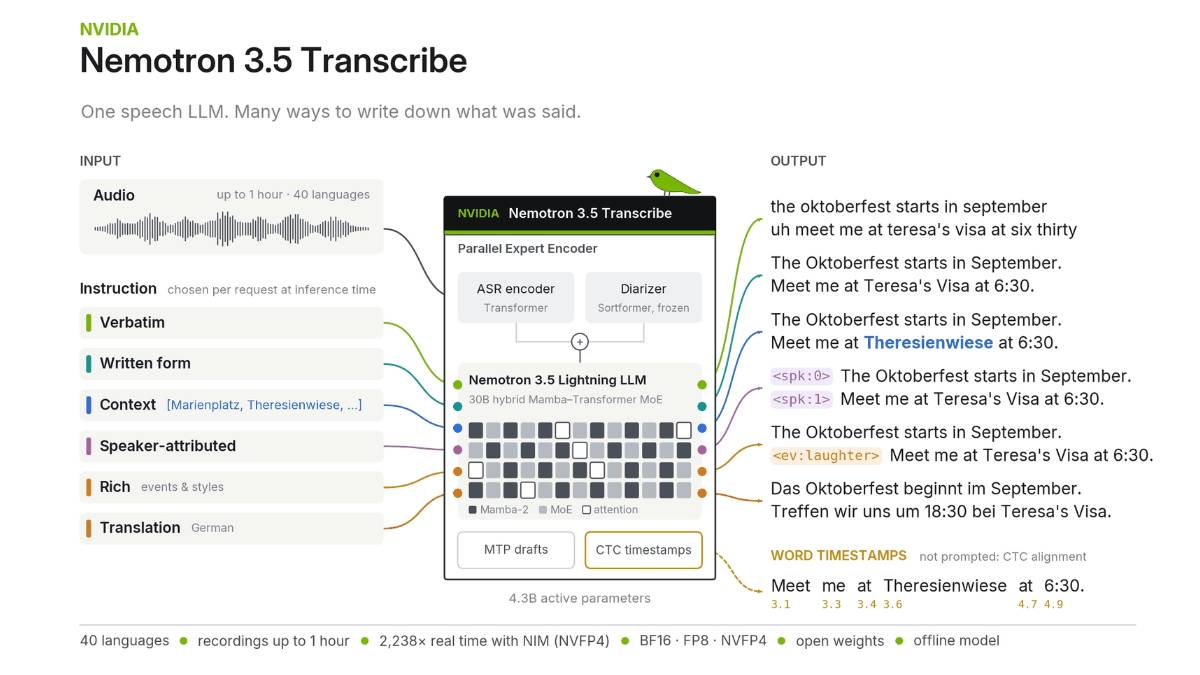
Nemotron3.5Transcribe是英伟达发布的开放权重多任务语音模型,采用混合专家架构,单模型即可完成语音转写、说话人区分、语音翻译、音频内容问答多项任务,无需拼接多个独立语音组件。支持最长一小时录音文件,最多识别8位不同说话人,覆盖40门语言转写,31门语言和英语互译,遵循OpenMDW‑1.1许可协议,权重发布于HuggingFace与 ModelScope,提供 BF16、FP8、NVFP4 多版本权重,本地硬件与云端环境均可部署,接收自然语言提示词来约束输出格式、注入行业专业术语。
Nemotron3.5Transcribe特点
提示词驱动工作模式,通过文本指令切换任务类型、输出格式,不用重新微调模型。
单模型整合转写、说话人标注、语音翻译、音频问答,减少多模型串联带来的误差累积。
支持最长一小时长音频输入,同段录音内识别最多 8 位说话人,13 种语言下完成说话人归属标记。
可传入领域专业术语列表,降低专有名词识别错误。
多档权重版本可选,适配不同算力硬件,支持私有化部署,音频数据不用向外传输。
支持语言混合交替的音频素材,处理会话中语种切换的录音文件。
Nemotron3.5Transcribe技术原理
整体由音频编码器与 MoE 语言主干两部分组成,总参数规模 34B,推理仅激活约 4.3B 有效参数。音频编码器提取音频时序声学特征,映射为统一表征送入混合专家语言主干网络。训练数据集收纳多语种录音、多说话人会议音频、翻译样本、音频问答配对样本。训练过程把任务指令和音频特征拼接输入,让模型依据提示词区分不同工作任务。针对长音频输入设置 64K 上下文窗口,维持长录音内说话人身份、对话内容的状态。术语提示分支接收外部传入专有名词列表,在解码阶段提升对应词汇输出优先级。
Nemotron3.5Transcribe功能
长音频文件语音转写,输出带标点的完整文本。
说话人归属标注,区分录音内不同发言个体,输出带说话人标记的文稿。
语音到文本翻译,将录音内容转为目标语种文本。
针对音频内容提出问题,基于录音内容给出对应回答。
接收术语清单,优化医疗、金融等垂直领域专有名词识别效果。
输出可配置格式的文稿,直接用于后续归档、分析流程。
Nemotron3.5Transcribe应用场景
企业会议、访谈录音处理,生成带说话人标记的会议纪要。
客服通话事后分析,解析通话内容,提取业务相关信息。
媒体机构处理多语种访谈素材,产出转写与翻译文稿。
医疗行业处理问诊录音,整理医患对话记录。
科研人员做多语种语音理解、说话人区分方向对照实验。
政企私有化语音解析业务,音频材料在本地服务器完成全部运算。
Nemotron3.5Transcribe如何使用
前往 HuggingFace 或者 ModelScope 下载 Nemotron3.5Transcribe 对应权重,选择 BF16、FP8 或 NVFP4 版本。
搭建 Python 运行环境,安装音频处理、transformers 相关依赖包,确认显卡显存满足权重运行条件。
加载模型权重,传入音频文件路径,编写自然语言提示词定义任务,例如转写、开启说话人标记、执行翻译。
可选步骤传入行业术语列表,减少专有名词识别错误。
提交推理,等待处理完成获取文稿、翻译文本或者问答结果。
长音频文件直接送入模型,无需手动切分片段,拿到带说话人 ID 标记的完整输出。
业务开发封装推理接口,对接自有业务系统,批量处理音频文件。
私有化场景隔绝外网,全部音频文件在本地硬件完成解析。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...