
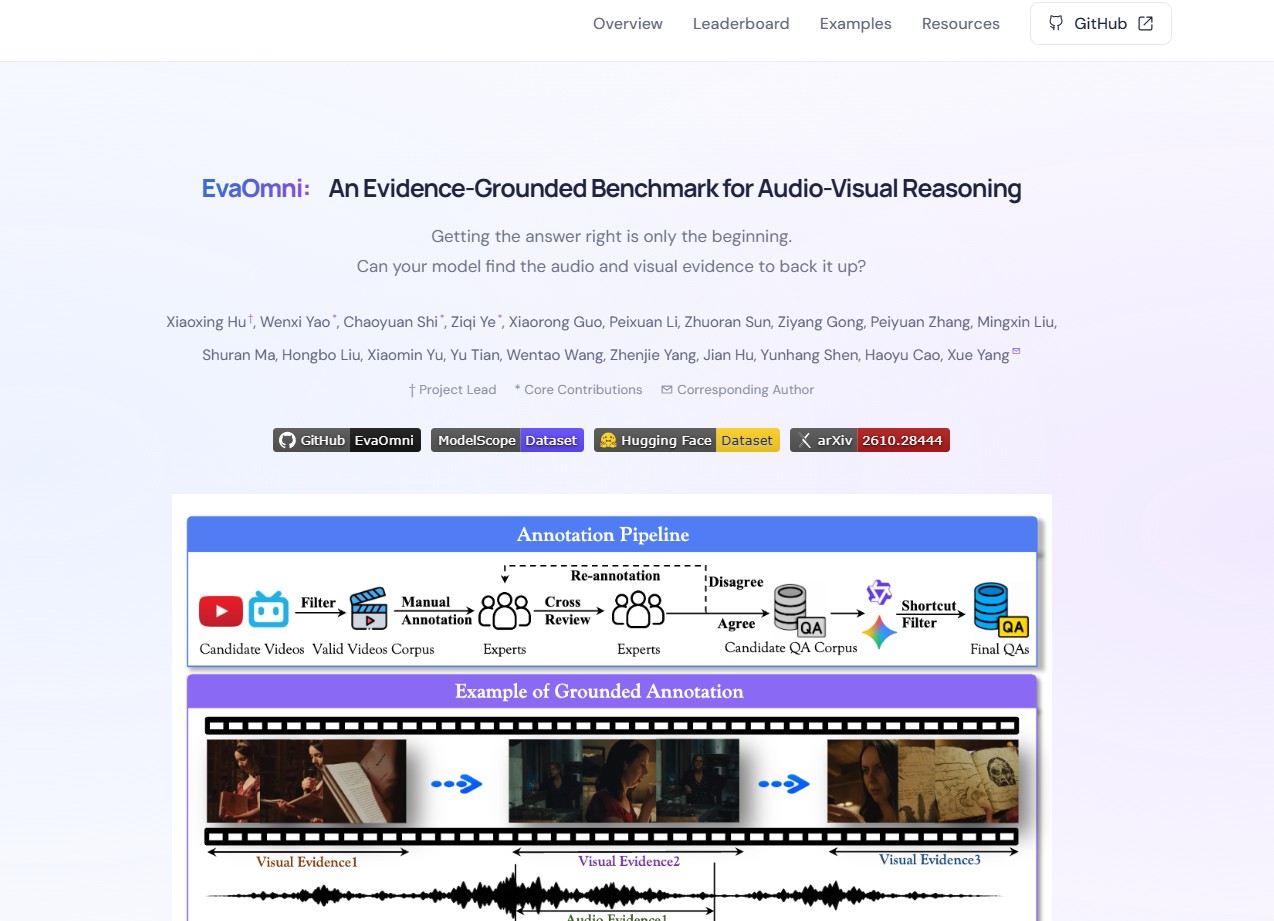
EvaOmni是面向音视频推理任务的证据锚定评测基准,数据集包含392段真实世界视频、1027条标注问答样本,划分15项细粒度能力与三级推理难度。该基准不只评判答案正误,还要求模型定位出支撑结论的带时间戳音频、视觉证据,引入覆盖grounded 得分、瓶颈grounded得分两套全新评价指标。项目完成24款全模态模型横向对比,能够暴露模型答对答案却找不到对应音视频证据的捷径问题。
EvaOmni特点
答案与证据双重评判机制,输出内容需要匹配时间戳标记的音频片段、画面片段。
划分三级推理层级,覆盖事件绑定、条件统计、多跳推理共15项细粒度能力。
经过多轮人工交叉校验,搭配纯文本、纯音频、纯视觉筛查,降低模型走捷径答对的情况。
设计三项量化指标,答案准确率、覆盖grounded得分、瓶颈grounded得分,瓶颈指标校验双模态证据同时定位能力。
收录真实拍摄视频素材,并非合成渲染数据,贴合现实音视频理解场景。
公开 24 款主流闭源、开源全模态模型的排行榜,呈现能力差距。
EvaOmni技术原理
每条样本保存原始视频、问答文本、标准答案,同时标注对应视觉证据时间区间、音频证据时间区间。评测脚本接收模型输出,解析答案文本、视觉时间戳、音频时间戳。答案准确率核对输出和标准答案匹配程度。覆盖 grounded 得分统计模型输出证据和标注证据重合占比。瓶颈 grounded 得分强制校验音频、视觉两类证据都被正确定位。整套评估流程会过滤仅依靠单模态信息就可以答对的样本,规避模型借助模态捷径拿到高分。
EvaOmni项目地址
- 项目官网:https://xiaoxing2001.github.io/EvaOmni.github.io/
- GitHub仓库:https://github.com/VisionXLab/EvaOmni
EvaOmni功能
对音视频大模型开展综合测评,统计答案准确率。
校验模型是否可以定位支撑答案的音频证据片段、画面证据片段。
输出覆盖grounded得分、瓶颈grounde 得分,衡量证据定位质量。
按照 15 项细粒度能力做分组统计,查看模型在不同子任务的表现。
导出排行榜结果,完成不同全模态模型横向对比。
提供样例集,用于调试音视频推理模型的证据输出逻辑。
EvaOmni应用场景
多模态算法研发,音视频理解模型迭代过程做效果验证。
学术科研,音视频推理、视频问答方向开展消融对照实验。
模型选型,对比多款音视频大模型的证据溯源能力。
数据集研究,时序多模态数据集构建、评测指标设计相关实验。
EvaOmni如何使用
访问EvaOmni项目网页,浏览样例、排行榜与项目说明文档。
前往HuggingFace或者ModelScope平台下载EvaOmni‑Dataset数据集。
克隆项目代码仓库,配置 Python 运行环境,安装视频处理、评测计算依赖包。
加载数据集,输入待测模型,传入视频样本,要求模型输出答案、视觉证据时间戳、音频证据时间戳。
运行评估脚本,自动计算准确率、覆盖 grounded 得分、瓶颈 grounded 得分。
按能力维度拆分评测结果,分析模型短板。
科研场景,基于现有脚本修改,自定义指标开展拓展实验。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...