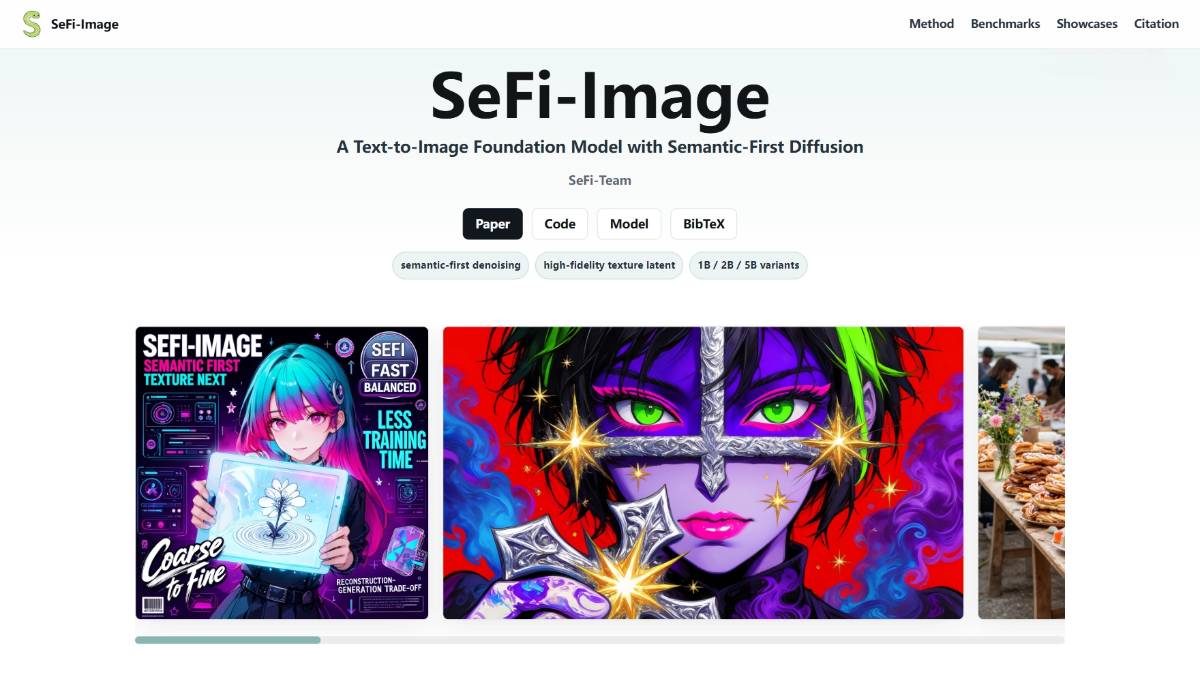
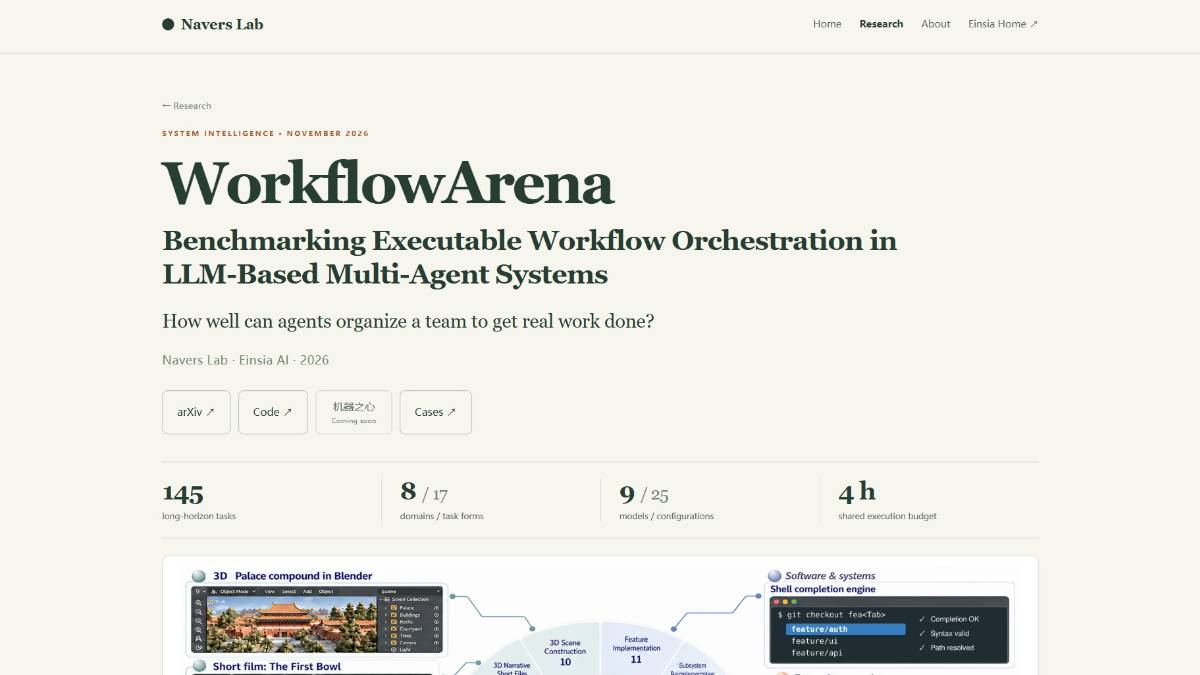
WorkflowArena是Navers Lab与EinsiaAI推出的多智能体编排评测基准,专门衡量大模型自主搭建、调度可执行工作流的实际能力,集合145项长周期真实任务,覆盖八大专业领域。现有评测大多只看任务最终结果,或是采用预先写死的协作框架,这套基准允许模型自主决定任务拆分、子智能体委派方式,不预设工作流结构。整套基准配套隔离容器环境、隐藏校验器、完整执行轨迹记录,可产出总体完成率与连续得分两套核心指标,面向主流大模型与智能体运行框架开展对照测试。
WorkflowArena特点
包含 145 项长周期真实业务任务,覆盖软件工程、企业运营、科学、形式数学、金融、法律、内容设计、3D 制作八大领域。
不预设智能体协作模板,模型自主选择是否委派任务、设置子工作者数量、编排并行与迭代流程。
采用隔离容器作为初始工作空间,任务交付物由隐藏校验器完成判定,组件拼接出错无法拿到完整合格分数。
记录全部工作流调用、子智能体调用轨迹,可分析不同模型的任务委派行为差异。
设置 4 小时全局共享执行预算,最多支持 16 个并发子工作者,还原真实多智能体资源约束。
提供两套评价指标,总体完成率代表任务全部达标占比,连续得分用于衡量部分推进阶段的产出质量。
支持静态、动态两类工作流模式对照,评估工作流脚本本身的可迁移效果。
WorkflowArena技术原理
全部任务素材取自公开真实业务场景,经过适配、筛选与人工复核,定义初始工作空间、交付契约、验收条件。任务运行于干净隔离容器,测试开始才导入公开输入与工具,校验逻辑与参考答案放置在容器外部。主智能体在预算限制下实例化子工作者,自行编写可执行工作流,系统完整记录每一次工作流调用、子工作者实例、信息传递内容。任务结束后隐藏校验器对整合后的交付物做判定,零散正确组件未完成整合不计入完整通过。静态模式直接执行模型生成的冻结工作流脚本;动态模式允许主智能体观察子任务输出,中途修改工作流逻辑。基准支持固定执行器对照实验,分离 “编写工作流的模型” 和 “实际干活的执行模型”,单独量化工作流脚本本身带来的分数增益。
WorkflowArena项目地址
- 项目官网:https://lab.einsia.ai/workflowarena
- GitHub仓库:https://github.com/Einsia/WorkflowArena
WorkflowArena功能
多智能体编排能力评测,在八大专业域下测试模型自主拆分任务、委派子智能体、组织协作流程。
执行轨迹采集,保存工作流调用频次、每个工作流下子工作者数量、token 消耗、耗时等全部运行信息。
双维度指标输出,输出各领域总体完成率、连续得分,汇总得到全局平均指标。
静态与动态工作流对照实验,验证一套工作流脚本迁移到其他执行模型上的实际收益。
模型‑Harness 组合对比,把大模型和对应智能体运行框架作为整体开展横向比对。
案例回放,保存完整任务执行过程,复现多智能体并行工作的全部步骤。
WorkflowArena应用场景
智能体算法科研,多智能体任务编排、任务委派策略方向消融对照实验。
大模型选型测试,对比不同模型在复杂长周期多子任务业务上的编排表现。
Agent Harness 框架迭代,评估运行框架对自主工作流生成、子智能体调度带来的影响。
工作流脚本研究,研究高质量工作流的特征,验证脚本跨模型迁移效果。
行业原型验证,面向法律、金融、3D 制作、软件工程等复杂业务的多智能体方案做效果摸底。
WorkflowArena同类产品对比
表格
| 项目 | WorkflowArena | WebArena |
|---|---|---|
| 开发方 | Einsia AI × Navers Lab | 学术团队(2024) |
| 产品类型 | 多智能体工作流编排评测基准 | 网页导航任务评测基准 |
| 核心亮点 | 145 个长程任务、覆盖 8 大专业领域(软件工程、形式数学、法律、金融、3D 生产等);只给初始工作区与最终交付物,不预设协作结构;模型自主决定是否委派、委派给谁;所有调度行为完整记录,隐藏判题器同时评估交付物质量与工作流组织方式 | 812 个真实网站导航任务,覆盖电商、论坛、协作开发、内容管理四类站点;基于可复现的本地环境,按轨迹功能正确性打分;是 Agent 网页操作能力的经典对照基准 |
| 适用场景 | 评估多智能体编排、团队分工与调度策略,对比不同模型的协作组织能力 | 评估单 / 多智能体的网页浏览、表单操作与网站任务完成能力 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...