
token数量越多,消耗的计算资源越多原因
Token数量确实是决定AI计算资源消耗(算力、显存、时间、成本)的最核心指标。 你可以把Token想象成AI处理信息的“基本积木”或“工作量单位”。无论是你输入的文字,还是AI生成的回答,每一个To...

一百万token相当于多少汉字
在中文语境下,一百万token大约相当于 60万 到 75万 个汉字。 换算规则:为什么是这个数? 在AI大模型(如 GPT-4、Claude、文心一言等)的底层逻辑中,Token是处理文本的最小单位...
embedding(嵌入或嵌入向量)通俗理解
Embedding,中文通常翻译为“嵌入”或“嵌入向量”。 如果用一句话来通俗解释:Embedding就是给计算机看不懂的文字、图片或声音,穿上了一件“数字化”的外衣,让计算机能够通过计算“距离”来理...
rag大模型5个基本参数
在构建和优化一个检索增强生成(RAG)系统时,有5个基本参数对最终效果起着决定性作用。调整这些参数,就如同为系统校准“视力”、“记忆力”和“创造力”,直接影响回答的准确性、相关性和可靠性。 1. To...
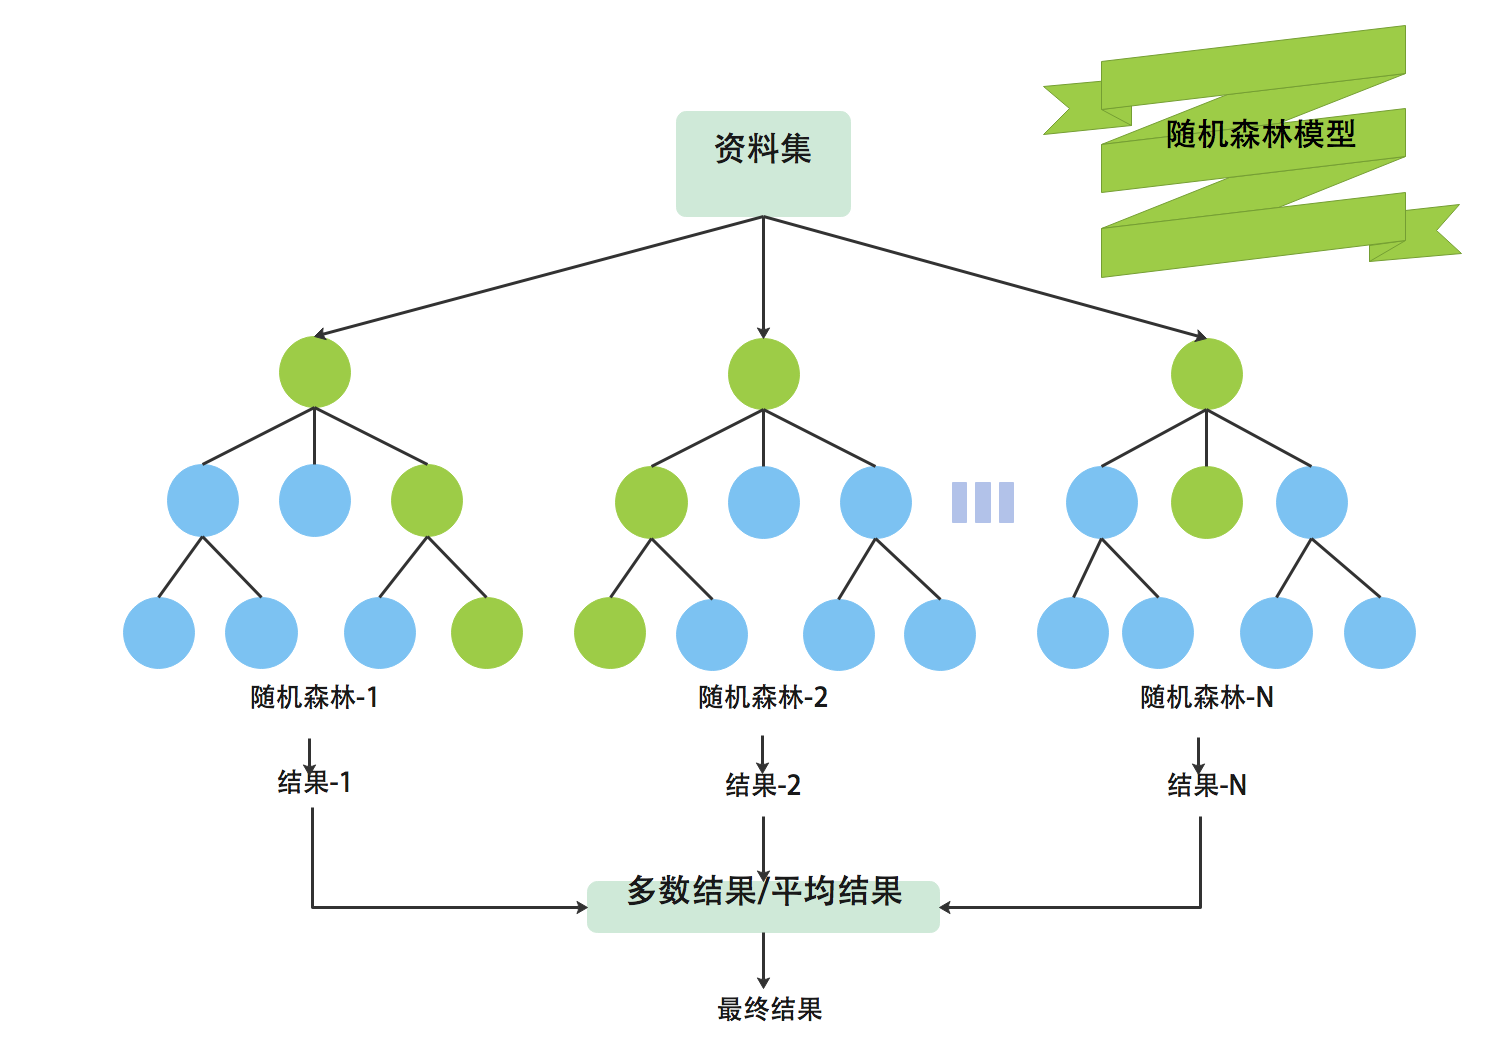
随机森林模型
随机森林(Random Forest)是机器学习领域中一种强大且应用广泛的集成学习算法。你可以把它想象成一个由众多专家(决策树)组成的“智囊团”,通过集体决策来得出更可靠、更准确的结论。 它之所以广受...
思维链CoT是什么
思维链(Chain-of-Thought, CoT)是一种引导大型语言模型(LLM)通过生成一系列中间推理步骤来解决复杂问题的技术。它的核心思想是模仿人类解决问题的过程,让AI不仅给出最终答案,还要...
Wan2.7-Video – 阿里巴巴发布的一款视频生成系列模型
Wan2.7-Video 是阿里巴巴发布的一款视频生成系列模型。它的核心特点是拥有全面的创作控制力,将 AI 的能力从单一的素材生成扩展至“生成、编辑、复刻、重塑”等创作全链路,实现了从被动“演绎”到...
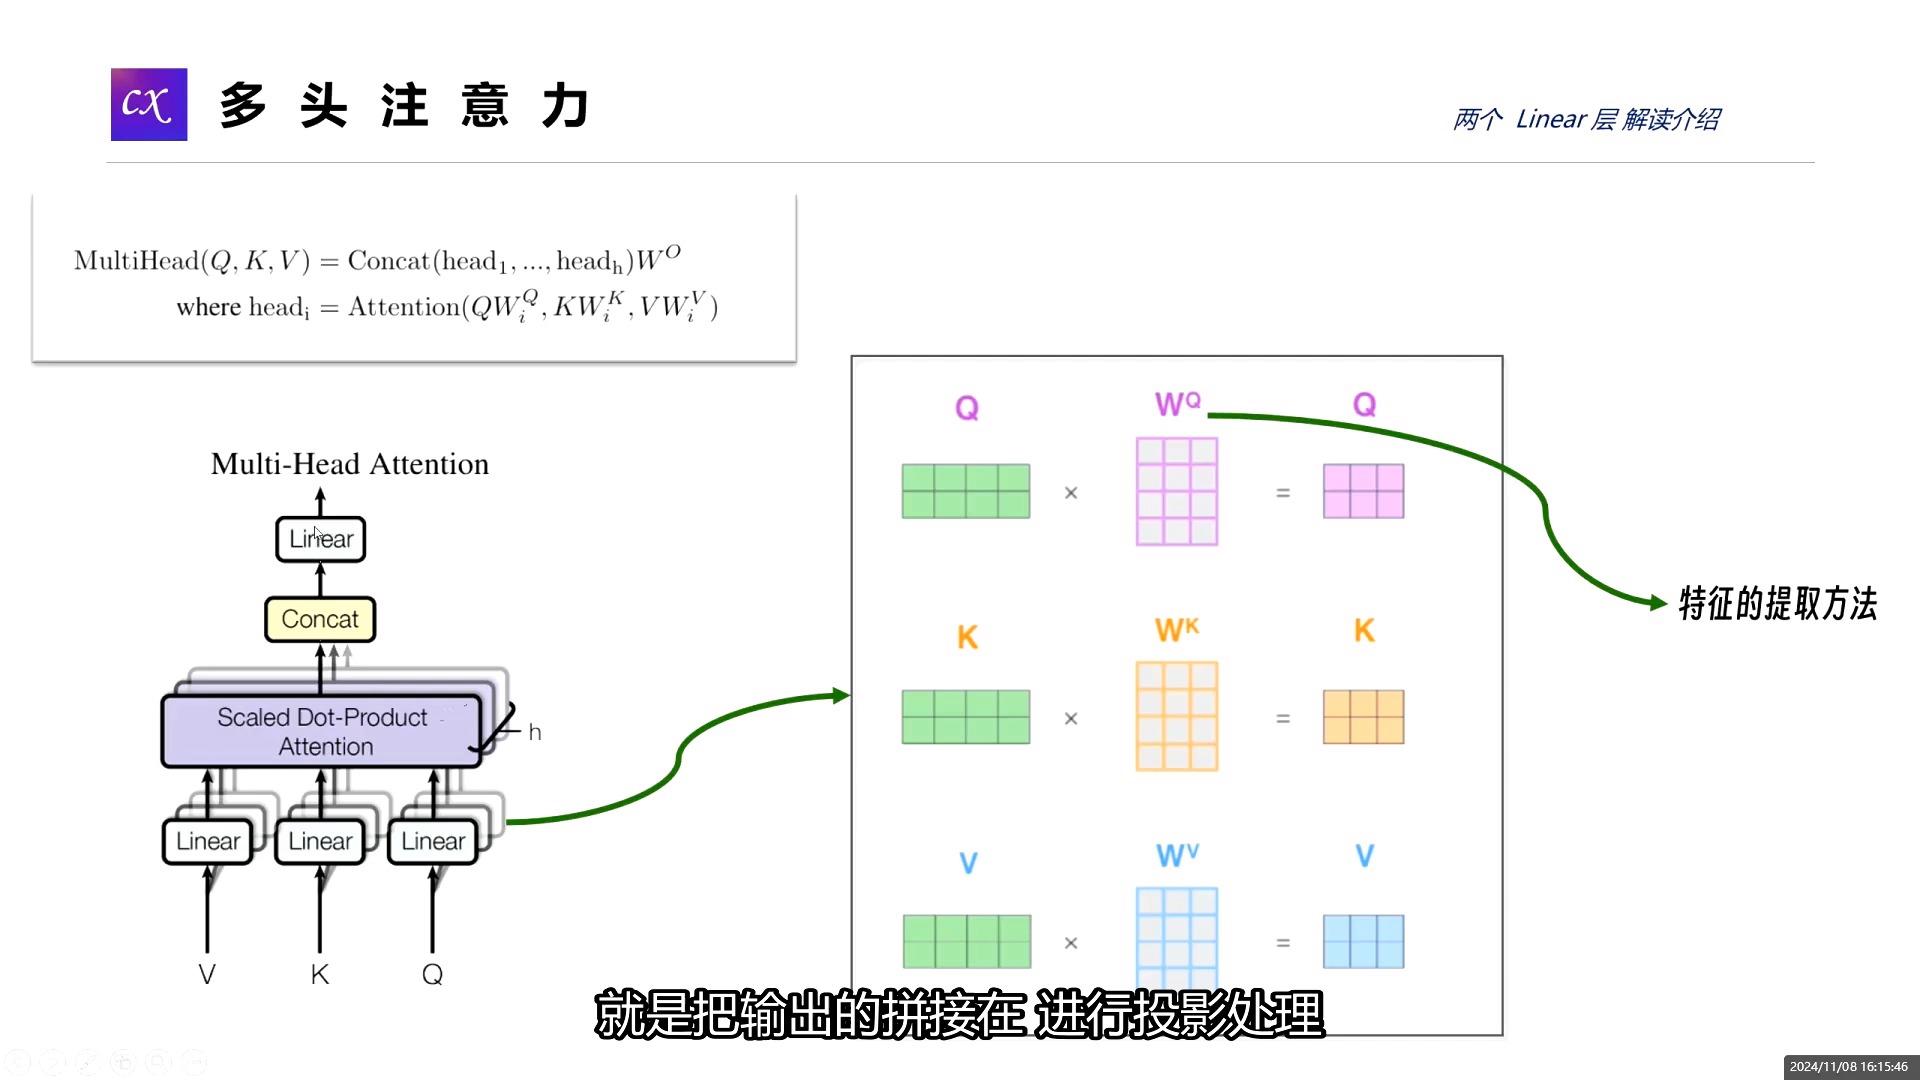
多头自注意力机制详解
多头自注意力机制(Multi-Head Self-Attention)是现代人工智能领域的基石之一,它是Transformer架构的核心组件,也是让 ChatGPT、BERT 等大模型能够真正“理解...
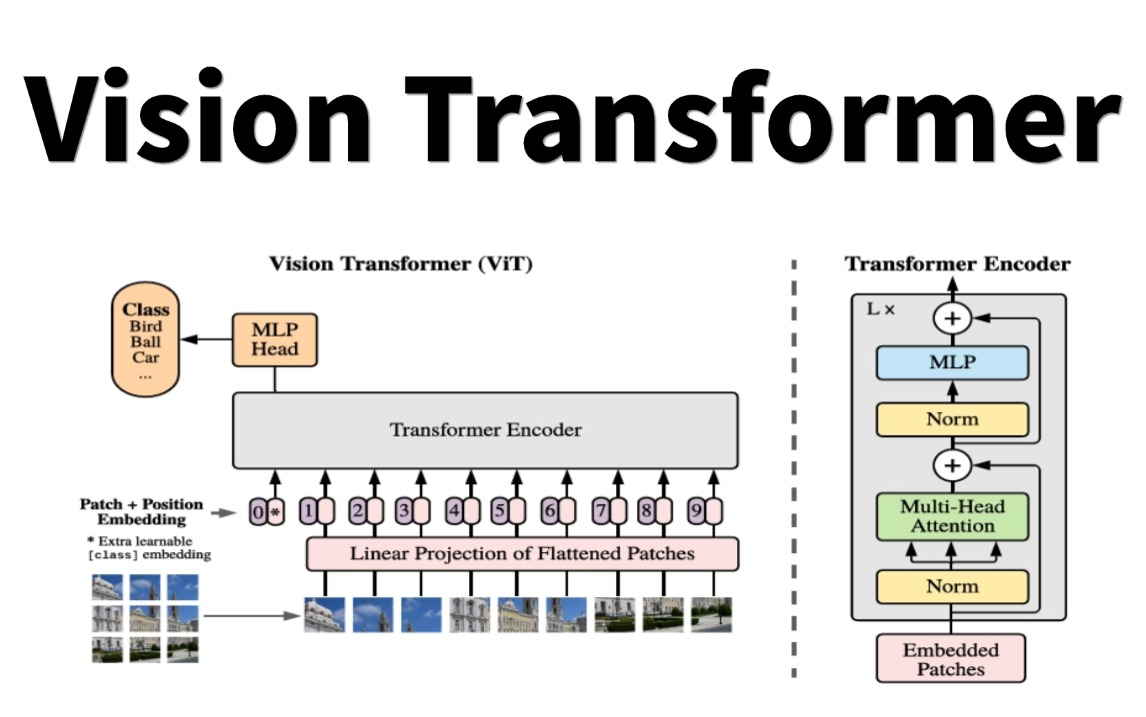
vision transformer模型详解
Vision Transformer (ViT) 是计算机视觉领域的一个里程碑式模型,它由Google Research团队在 2020 年提出。ViT的核心突破在于,它打破了卷积神经网络(CNN)在...
人工智能的本质是什么
人工智能本质是模拟人类感知、思考、决策与创造能力的技术体系。依托算法、大数据与算力,让机器复刻人脑逻辑,自主学习规律、处理信息、预判问题。 它不再局限固定指令执行,可通过海量数据迭代优化行为,完成识别...