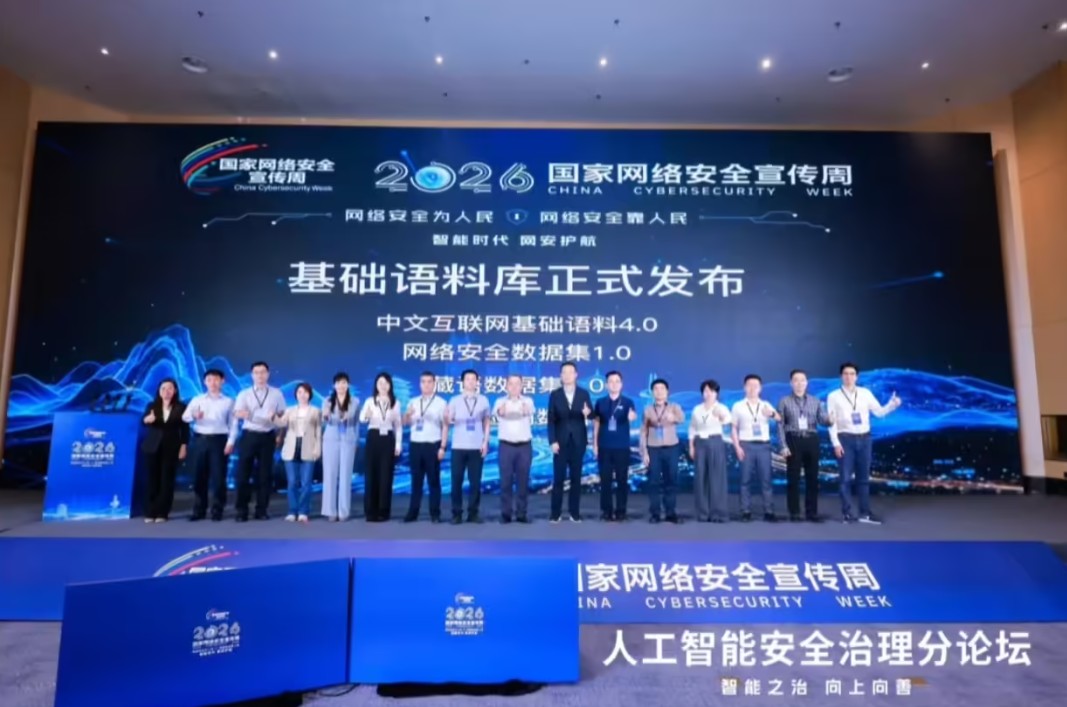
中文互联网基础语料 4.0 是中国网络空间安全协会牵头推出的中文互联网数据集,在 2026 国家网络安全宣传周人工智能安全治理分论坛对外发布,整体数据规模 120GB。该版本在 1.0 至 3.0 版本基础上迭代,联合多家科技企业共建,经过多层清洗、质检与合规过滤流程。整套资源托管于中文互联网语料资源平台,机构用户完成注册与资质认证后获取,为中文大模型预训练、对齐评测提供合规基础文本素材,补齐国内可信中文基础数据供给。
中文互联网基础语料4.0特点
依托多方共建共享机制汇聚素材,集合多家机构的数据采集与审核能力,覆盖互联网多领域中文文本内容。
执行多层数据清洗流程,剔除低质、重复、违规内容,保留语义通顺、信息完整的文本片段。
具备完整合规审核链路,规避版权与内容风险,降低模型训练阶段引入不良信息的概率。
数据覆盖领域宽泛,包含科普、行业资讯、日常文本、知识性内容,适配通用中文语言能力构建。
版本迭代延续前序版本的建设思路,扩充样本多样性,优化文本质量判定标准。
开放面向机构申请获取,配套平台管理体系,记录数据使用主体,便于追踪数据集流转。
中文互联网基础语料4.0技术原理
数据源采集环节对公开互联网网页做定向抓取,提取页面正文文本,剥离标签、广告、导航栏等无效内容。
数据清洗模块执行重复文本去重、乱码过滤、低质量短句剔除,通过多维度质量打分机制筛选保留有效样本。
内容安全模块对文本做多层检测,识别违规内容、偏见表述,过滤不适宜进入模型训练的样本。
文本做统一格式归一化处理,统一编码、分段规则,输出标准化文本文件,适配主流大模型预训练读取格式。
样本按照题材、领域做分类归档,支持使用者按需抽取子集,开展模型训练与基准测试。
中文互联网基础语料4.0功能
大模型预训练素材供给
提供大规模中文原始文本,用于基座模型预训练,学习中文语法、词汇与常识知识。
模型对齐与微调
抽取子集用于监督微调,调整模型输出风格,校准中文表达习惯。
中文模型基准评测
选取样本子集搭建评测集,测试模型中文理解、知识问答能力。
数据研究实验
开展中文语料质量、数据过滤算法、数据污染检测相关实验。
行业小模型训练
从中抽取垂直领域片段,训练面向特定场景的中文小语言模型。
中文 NLP 任务开发
用于文本分类、实体识别、摘要等传统自然语言处理任务的训练与验证。
中文互联网基础语料4.0应用场景
大模型研发企业
用作中文基座模型预训练基础数据,搭建通用大模型,降低外部数据采购成本。
AI 科研院所
开展数据治理、大模型训练、中文语言能力相关课题研究。
高校人工智能实验室
用于自然语言方向课程实验,完成数据集处理、模型训练实训。
安全评估机构
构建中文 AI 安全测试样本,评估模型内容输出风险。
中小 AI 项目团队
获取合规基础中文数据,快速开展小模型原型开发。
数据治理研究团队
测试文本清洗、去重、内容过滤算法效果,优化语料处理流程。
中文互联网基础语料4.0同类产品对比
表格
| 对比项 | 中文互联网基础语料 4.0 | CCI 4.0(智源中文互联网语料) |
|---|---|---|
| 研发主体 | 中国网络空间安全协会、国家互联网应急中心,联合百度、科大讯飞等企业共建 | 北京智源研究院,联合多家 AI 企业共建 |
| 产品定位 | 合规可信的中文互联网基础预训练语料库,侧重安全治理与合规审核 | 大规模中英双语开源预训练数据集,兼顾基础文本 + 思维链合成数据 |
| 核心特色 | 120GB,严格合规过滤、安全风险筛查,面向国内大模型可信训练,走申请认证获取 | 总量 35TB,中文子集规模大,内置 CoT 推理合成数据,可直接开源下载,多轮质量过滤 |
| 适用场景 | 政企机构大模型训练、合规 AI 研发、安全可控的中文基础模型预训练 | 通用大模型预训练、推理能力增强实验、高校科研开源项目 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...