Grok Voice Transcribe 2.0 是 xAI 推出的语音转文字模型,依托云端 API 对外提供批量音频转写与实时流式转写服务。新版本在保持原有计费标准的前提下,识别准确率相比上一代实现大幅提升,面向嘈杂环境、多语种混合对话、多人交谈场景优化识别能力。模型覆盖 25 种语言,支持录音文件、网络音频地址以及实时音频流输入,自动识别语种并处理同一段音频内的语种切换。输出内容附带词级时间戳、置信度指标,自带说话人区分能力,可适配企业业务系统接入,为语音智能体、会议记录、客服质检等场景提供稳定的文字转化能力。
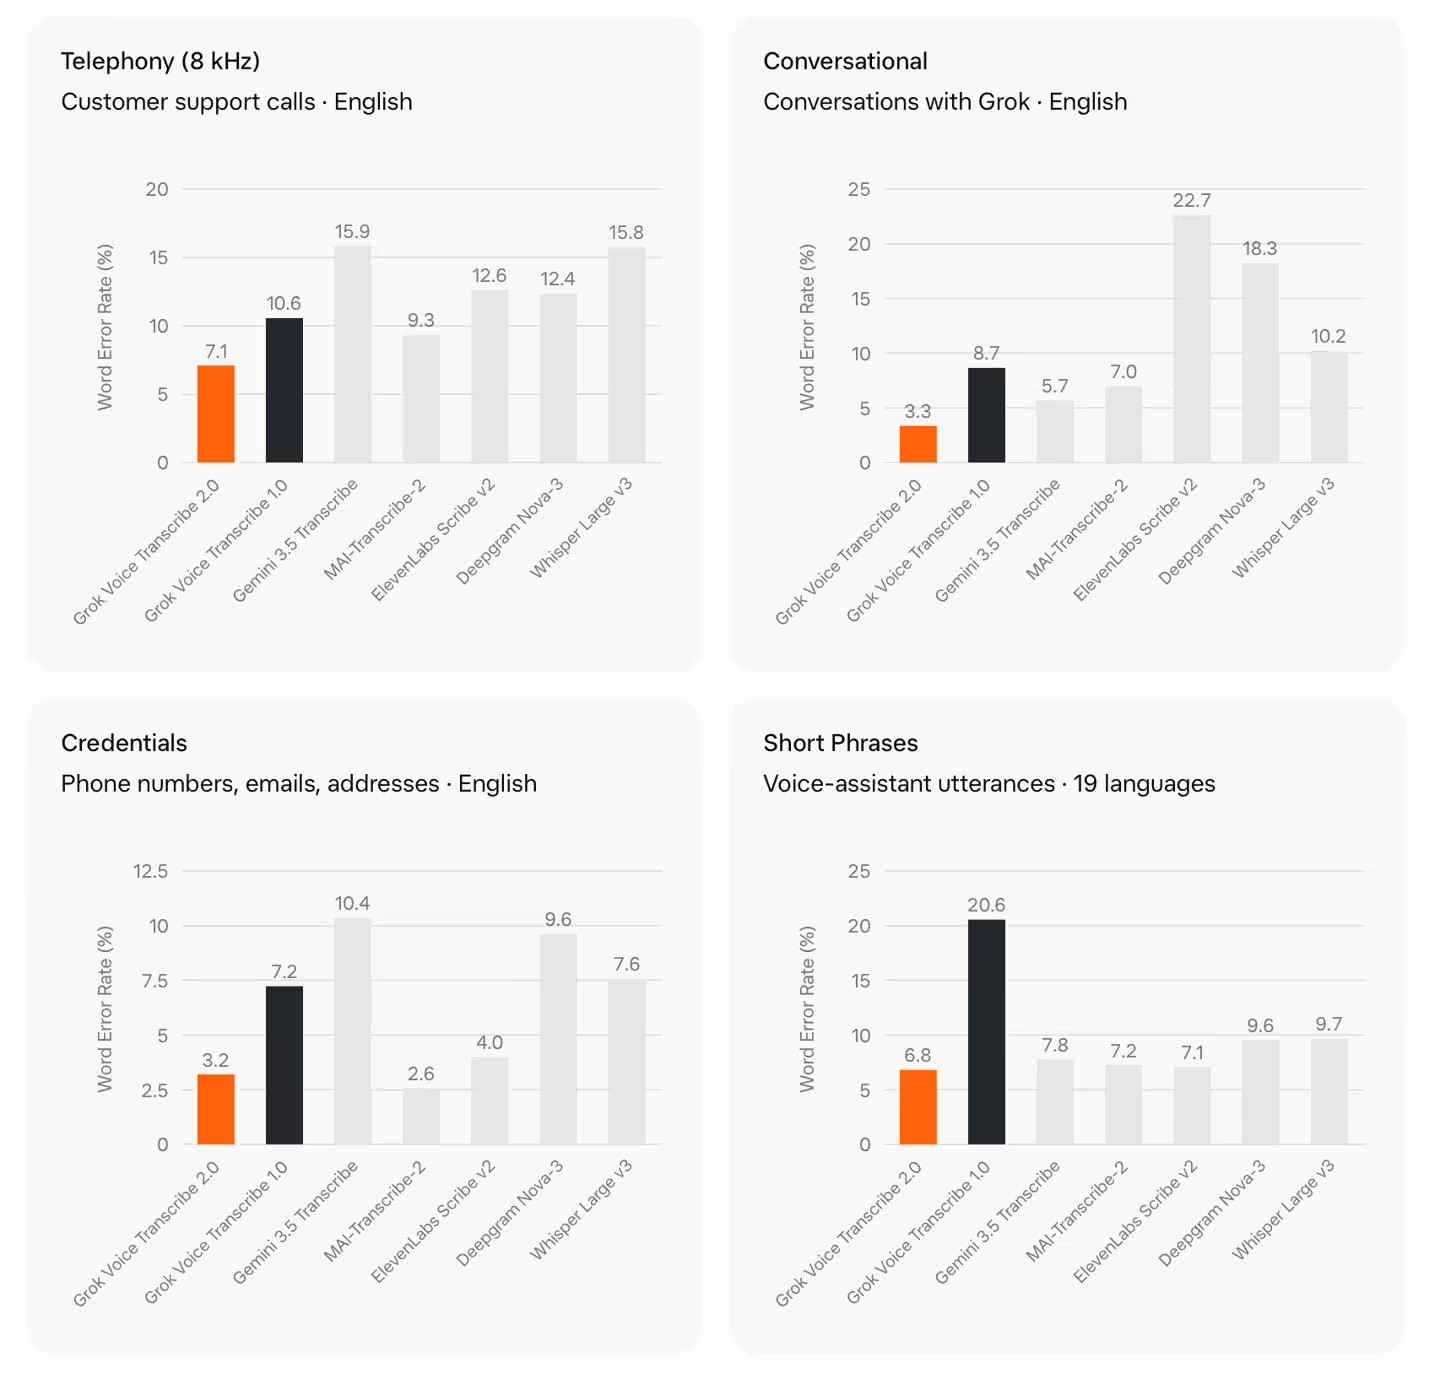
Grok Voice Transcribe 2.0特点
针对嘈杂环境、电话压缩音频做专项优化,嘈杂场景识别表现优于多数同类转写模型。
多语种识别能力强化,短语句识别错误率明显下降,支持同段音频内语言切换识别。
API 兼容原有接口,存量业务接入无需改动代码。
支持最多 8 声道音频解析,单请求可录入 100 条行业专属词汇,强化专业术语识别。
自动规整数字、日期、货币、联系方式格式,可过滤语气填充词。
内置对话断句检测,适配实时语音交互场景。
兼容 WAV、MP3、WebM 等 12 种主流音频格式,文件上限支持 500MB。
Grok Voice Transcribe 2.0技术原理
模型采用端到端语音编码解码架构,原始音频信号经过声学编码器提取声学特征,再送入语言解码器完成文本生成。
训练素材取自大量真实环境录音,包含背景噪音、电话线路压缩、各地口音、多语种混讲音频。
训练过程优化词错误率指标,针对行业术语构建词表偏置机制,调整模型对指定关键词的输出权重。
流式推理模块采用增量解码,持续接收音频分片并输出中间结果,降低端到端延迟。
说话人区分模块提取声纹特征,区分不同发言者,同步生成每个词汇的时间标记与置信评分。
Grok Voice Transcribe 2.0功能
批量音频转写,上传本地音频文件或者传入音频 URL,一次性完成完整录音转文字。
实时流式转写,通过 WebSocket 接收音频流,边接收边返回文本片段。说话人分离,自动标记不同发言者,区分多人对话内容。
词级时间戳输出,记录每个字词起止时间,附带识别置信度。
行业术语增强,自定义专业词汇,提升特定领域内容识别效果。
文本自动格式化,数字、时间、金额、邮箱、电话自动转为规范书写形式。
填充词过滤,选择性剔除语气助词,精简转录文稿。
对话停顿检测,识别说话语句结束节点,适配实时语音交互开发。
Grok Voice Transcribe 2.0应用场景
线上会议记录,把远程会议音频转为文稿,留存发言内容,方便后续检索整理。
客服通话质检,批量解析电话录音,提取对话文本,用于业务审核与内容分析。
多媒体内容制作,播客、访谈、视频素材快速生成字幕原稿,降低字幕制作工作量。
跨境语音业务,处理多语种、混语种对话,适配海外客服、跨国访谈项目。
语音智能体开发,作为底层语音识别模块,接收用户语音指令,输出文本送入大模型处理。
媒体归档,将历史录音素材批量数字化,建立可检索的文本资料库。
Grok Voice Transcribe 2.0如何使用
- 注册 xAI 开发者账号,获取 API 密钥,确认接口调用权限与账户余额。
- 根据业务需求选择模式,批量任务选用 REST 接口,实时对话场景选用 WebSocket 流式接口。
- 准备音频素材,确认音频采样率、编码格式,文件大小控制在 500MB 以内。
- 配置请求参数,填入音频资源,按需添加自定义行业词汇列表,开启说话人分离、填充词过滤功能。
- 发起接口调用,等待服务端返回转录结果,获取完整文本、时间戳、说话人标记、置信数据。
- 调试输出格式,对返回文本做二次处理,接入业务系统或者导出文档。
- 压力测试,评估并发调用、音频长度对应的响应速度,完成正式上线部署。
Grok Voice Transcribe 2.0同类产品对比
表格
| 项目 | Grok Voice Transcribe 2.0 | Deepgram Nova-3 |
|---|---|---|
| 研发主体 | xAI | Deepgram |
| 产品定位 | 云端流式 + 批量语音转写 API 模型,面向嘈杂电话、多语种实时对话场景 | 商用流式语音识别模型,主打低延迟实时语音转写 |
| 核心特色 | 支持 25 种语言,自带说话人分离、时间戳,嘈杂电话音频准确率优秀,批量 0.1 美元 / 小时 | 极低流式延迟,原生支持说话人区分,适配客服、会议实时转写,生态成熟稳定 |
| 适用场景 | 电话客服录音、多语种混合对话、视频旁白转录、车载语音智能体 | 线上会议实时字幕、呼叫中心实时语音 Agent、直播语音转写 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...