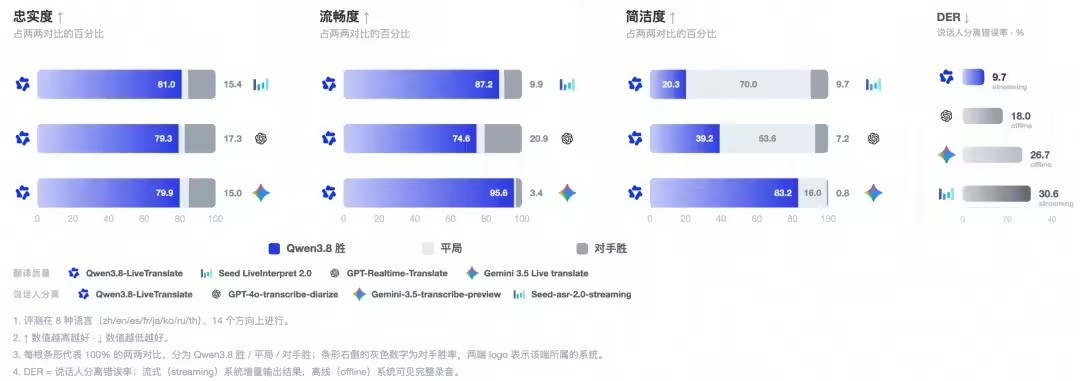
Qwen3.8-LiveTranslate 是阿里通义千问推出的多模态实时同声传译模型,依托 Hybrid MoE 与 Thinker–Talker 双模块架构打造,面向音视频实时跨语言交互场景。模型覆盖 60 种语言互译,其中 29 种语种支持音频输出,字均延迟压缩至 2.3 秒,大幅拉近与人工同传的响应差距。模型接入视频画面信息辅助语义判断,结合长上下文消歧机制处理一词多义问题,多人对话场景可自动区分发言主体,同步输出双语对照文本,还能复刻发言人音色生成译文语音,开发者可通过阿里云百炼平台的 WebSocket 流式接口接入,搭建各类实时翻译业务。
Qwen3.8-LiveTranslate特点
多语种覆盖范围广,支持 60 种语言互译,不同语种可在同一段对话内切换识别。
音视频多模态输入,画面里的口型、字幕、场景信息可以辅助语义判断,降低歧义带来的翻译偏差。
极低的同传延迟,音频输入后快速输出译文,满足直播、会议等对实时性要求严苛的业务。
内置说话人区分逻辑,多人交替交谈时自动划分语句归属,减少发言内容混淆。
支持热词配置,自定义行业术语,提升专业场景翻译准确度。
音色复刻输出,译文语音保留原说话人的声线特征。双语内容同步推送,原文译文成对返回,便于页面双栏展示。
Qwen3.8-LiveTranslate技术原理
模型采用 Hybrid MoE 混合专家架构,搭配 Thinker–Talker 双模块与 Interleave 时序交织机制。
Thinker 模块接收音频编码器、视觉编码器输出的特征,将音频、视频帧、原文、译文编排进统一因果序列,按时序交替完成流式理解与翻译计算。
Talker 模块接收 Thinker 输出的译文文本,结合源音频的声纹信息,合成对应音色的目标语言语音。
长上下文消歧模块持续缓存对话历史,依托前文语境修正词汇释义。
流式推理框架分片接收音频信号,不用等待整段音频接收完毕,分段输出翻译结果,控制整体时延。
Qwen3.8-LiveTranslate功能
实时同声传译,接收流式音频或视频流,边接收边输出目标语言文本与语音。
说话人区分,多人对话自动标记每一段发言对应的发言人,输出分段记录。
双语对照输出,原文与译文同步返回,用于双语字幕、会议文稿展示。
语音音色复刻,翻译后的语音保留原说话人声线,听觉体验连贯。
热词自定义录入,导入行业专有名词、品牌词,优化专业内容翻译效果。
多模态语义增强,读取视频画面信息,消除同音多义、场景歧义问题。
批量音视频文件翻译,上传完整音视频素材,一次性生成字幕文稿与配音音频。
Qwen3.8-LiveTranslate应用场景
国际会议同传,跨国论坛、学术研讨会搭建线上实时翻译通道,生成双语会议记录。
跨境直播翻译,海外带货直播、海外内容直播实时生成双语字幕与配音。
涉外线上课堂,跨国网课、远程培训,同步转换授课语言,降低语言障碍。
跨境商务谈判,远程跨国洽谈,实时翻译双方对话,留存完整双语对话记录。
多媒体内容本地化,访谈、纪录片素材批量翻译,产出字幕与配音素材。
跨境客服系统,接入实时语音翻译,处理不同语种客户的语音咨询。
Qwen3.8-LiveTranslate如何使用
登录阿里云 Model Studio 百炼平台,开通模型调用权限,创建 API 密钥。
选择 WebSocket 流式接口,适配实时音视频流;文件翻译任务选用 REST 接口。
准备音视频采集设备,确认音频采样参数,视频流同步推送画面信息。
按需配置热词表,录入项目涉及的专业名词,开启说话人分离、音色复刻功能。
建立长连接,持续推送音频分片与视频帧,接收接口返回的原文、译文与语音流。
前端对接返回数据,渲染双语对照字幕,播放合成后的目标语言语音。
完成业务测试,调整缓存长度与热词参数,上线投入正式业务使用。
Qwen3.8-LiveTranslate同类产品对比
表格
| 项目 | Qwen3.8-LiveTranslate | Gemini 3.8 Live |
|---|---|---|
| 研发主体 | 阿里通义实验室 | Google DeepMind |
| 产品定位 | 端到端多模态实时同传模型,音视频输入、流式双语输出 | 多模态实时对话模型,支持实时语音翻译与交互 |
| 核心特色 | 字均延迟低至 2.3 秒,60 种语言,支持说话人分离、音色复刻、原文译文同帧输出、长上下文术语消歧 | 原生多模态实时流式交互,多语种语音互译,视觉信息辅助理解,对话交互能力强 |
| 适用场景 | 国际会议同传、跨境直播翻译、线上商务谈判、远程课堂实时翻译 | 跨国实时对话、视频通话翻译、多模态交互场景、远程多人沟通 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...