
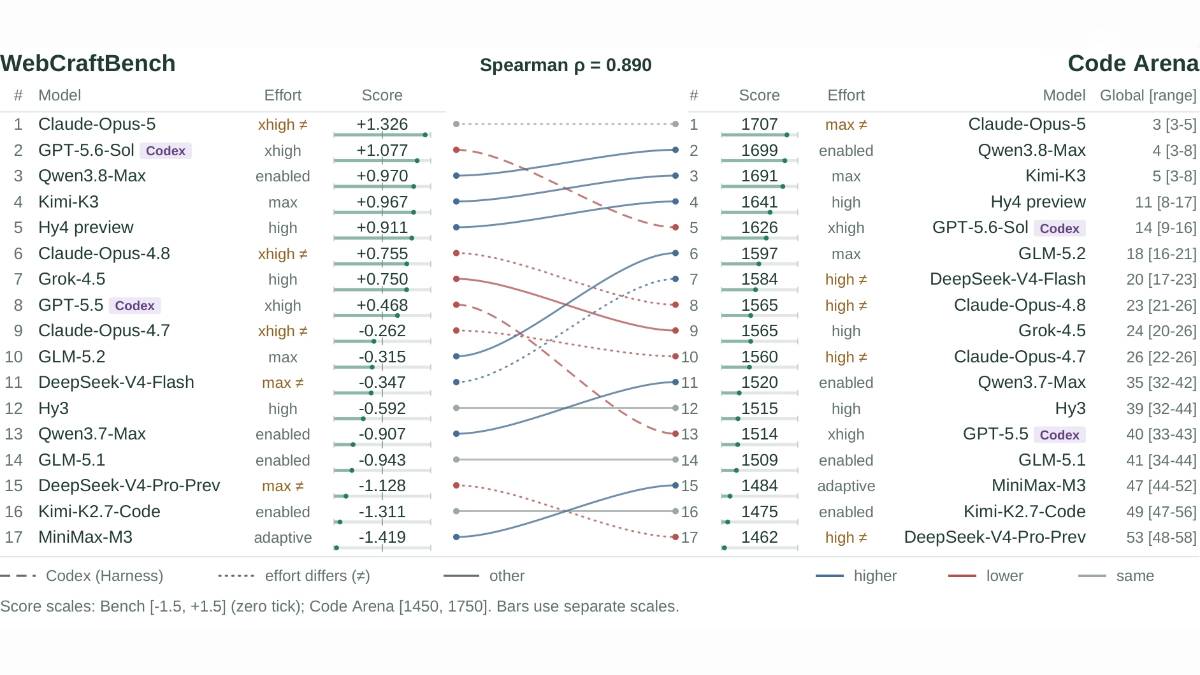
WebCraftBench 是由腾讯混元联合高校团队推出的 AI 网页生成评测框架,打破传统静态截图打分的评测思路,把软件测试流程引入网页生成质量校验。它依托真实用户需求构建测试用例,借助智能代理模拟普通人操作网页,从多维度量化 AI 产出页面的实际表现。整套基准数据集包含数百条真实需求与数千条验收标准,实测和人工主观判断的匹配度很高,能更贴近真实使用场景判断网页好坏。
WebCraftBench特点
区别于只看页面渲染结果的静态评测,这套框架走交互测试路线。
自动代理会主动点击按钮、填写表单、切换页面,挖掘代码逻辑层面的缺陷。
打分维度分开,视觉美观度、功能可用性、需求匹配度独立输出结果,不会出现单一指标拉高整体分数的情况。
测试流程可复现,更换打分主体不会大幅改变模型排名,方便开发者横向对比不同大模型的网页生成能力。
WebCraftBench技术原理
系统会对 AI 生成的网页代码做插桩处理,采集页面运行时的代码覆盖数据。
内置智能代理按照任务指令在网页内完成一系列操作,记录全部交互轨迹,再把操作序列整理成状态转移图。
后台校验模块对照预设验收条件,分别核算各项得分。
代码覆盖率用来判断代理有没有触达页面隐藏分支,避免只测试页面表层可见功能,漏掉弹窗、异常提交等边缘逻辑。
WebCraftBench功能
批量发起不同模型的网页生成任务,自动跑通整套交互测试。
输出分项得分报告,标注页面失效功能、布局错位、交互逻辑 bug。
统计代码覆盖情况,定位模型容易出错的任务类型。
汇总多模型横向对比数据,直观呈现各自强弱项。
产出测试日志与交互轨迹,方便研发定位网页生成失败的根因。
WebCraftBench应用场景
大模型研发团队用来迭代网页生成能力,快速验证版本改动带来的效果变化。
AI 网页工具厂商做版本验收,上线前批量排查功能漏洞。
学术研究领域开展网页生成相关实验,提供统一、可复现的评测基线。
开发者挑选适合网页开发的大模型,用统一基准完成选型对比。
WebCraftBench如何使用
准备好待测试大模型接口,配置 WebCraftBench 运行环境。
导入内置任务集,也可以自定义新增业务相关的测试需求。
启动评测任务,框架调用模型生成网页,自动启动代理执行交互操作。
任务跑完导出完整评测报告,查看分项分数、bug 清单、代码覆盖率数据。
对照报告调整模型提示词或者模型参数,再次复测,观察指标变化。
WebCraftBench同类产品对比
表格
| 评测基准 | 研发主体 | 产品定位 | 核心特色 | 适用场景 |
|---|---|---|---|---|
| WebCraftBench | 腾讯混元 + 清华 + 北大 | AI 网页生成专项评测基准 | 从美观度、可用性、需求合规性三维打分,基于真实用户需求,Agent 交互式探测 + 代码覆盖率评估,和人工偏好一致性高 | 评估大模型生成完整可交互网页、前端代码产出质量 |
| WebArena | 斯坦福 | 网页 Agent 操作能力评测基准 | 预置大量真实网站环境,侧重浏览器内点击、填表、导航等网页交互任务,评估 Agent 上网执行任务能力 | 测试智能体浏览、操作已有网页,而非生成网页 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...