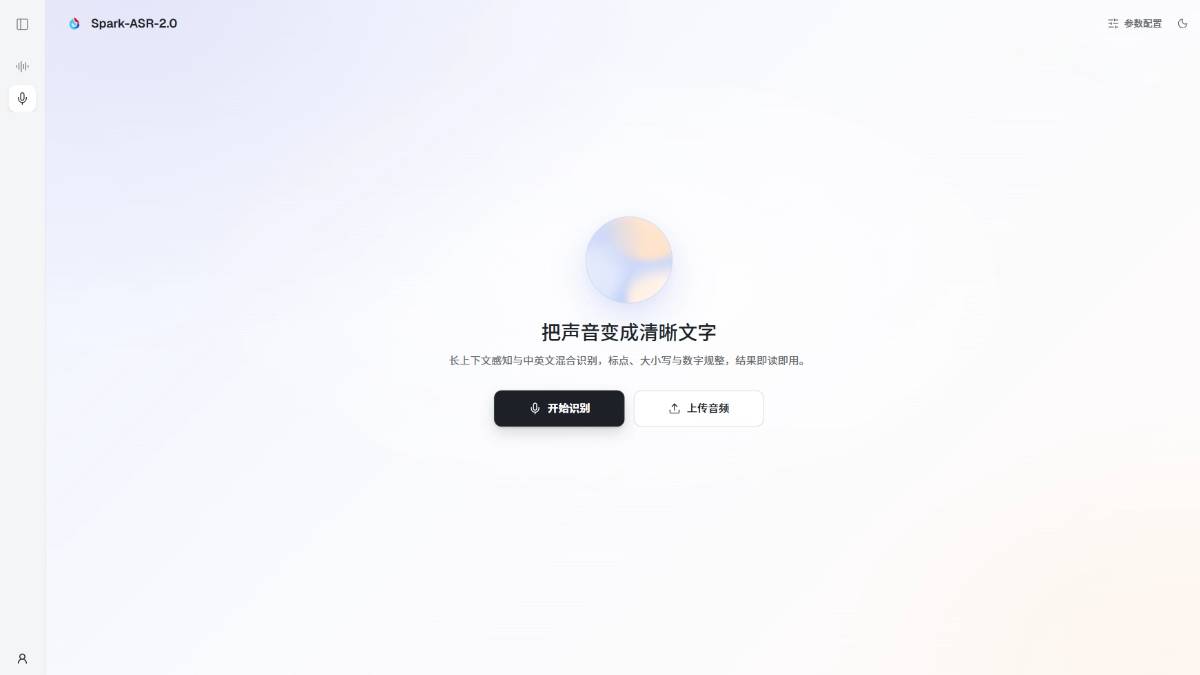
Spark-ASR-2.0 是科大讯飞推出的新一代语音识别大模型,依托 Spark-Audio-1.0-Preview 语音基座大模型开发,采用全国产算力完成训练。模型跳出传统语音识别单纯还原语音文字的思路,在转写过程中加入语义层面的文本润色,直接输出通顺可读的文稿。音频输入包含嘈杂环境、小声语音、快速口语、儿童语音、中英混杂对话等复杂类型,对各类方言与行业专业词汇具备较强适配能力。推理开销控制在合理区间,性能提升不会带来成本的大幅上涨,可落地到各类硬件终端与云端业务接口。
Spark-ASR-2.0特点
Spark-ASR-2.0 在高噪声环境下维持稳定识别效果,适配多样的语音输入条件。
处理中英混合对话、地方方言、行业术语时,词错误率相比前代模型明显下降。
输出文本自带整理能力,自动剔除口语重复、口误、多余语气助词,交付可直接阅读的成文内容。
上下文信息可持续参与识别推理,长段落对话里的指代内容、专有名词可以保持统一。
模型推理开销小幅增加,兼顾识别质量与业务部署成本。
支持端侧设备轻量化部署,可在智能硬件上完成本地语音转写。
Spark-ASR-2.0技术原理
模型融合非自回归语音编码网络与 LLM 增强自回归分支,两条路径协同处理音频信号。
声学编码器将音频波形转换为声学特征,完成声音信号到语言信息的初步映射。
声学与文本联合增强模块对中英混合样本、方言样本做特征优化,减少噪声对识别结果的干扰。
动态上下文注入机制把历史对话信息送入模型,利用前文内容校正当前片段的识别结果。
语言大模型分支负责文本后处理,修正错字、规整语句结构,压缩口语冗余内容。
整套训练流程基于国产算力集群完成,适配国内算力基础设施。
Spark-ASR-2.0功能
流式实时语音转写,接收持续音频流并分段输出识别文字。
离线音频文件解析,支持录音文件批量转文字。
中英文混合识别,自动区分语句内中文与英文词汇。
多类方言识别,覆盖国内主流方言体系。文本自动规整,清理口语赘余内容,优化语句可读性。
输出文字附带时间戳标记,定位每段语音对应的文本位置。
API 接口对外提供调用能力,支持第三方系统接入。
Spark-ASR-2.0应用场景
线上会议记录,实时生成会议文稿,减少人工整理耗时。
课堂授课录音转写,整理教学内容形成课堂笔记。
媒体采访素材处理,快速将采访录音转为文字稿件。
智能硬件语音采集,办公本、AI 眼镜等设备采集语音并生成文本。
客服语音质检,对通话录音做文字解析,辅助业务审核。
医疗、法律等专业场景录音转录,识别领域内专业词汇。
Spark-ASR-2.0如何使用
- 进入科大讯飞开放平台,注册开发者账号,创建应用项目,获取 API 调用密钥。
- 选择 Spark-ASR-2.0 模型接口,区分实时流式识别与离线文件转写两种调用模式,配置采样率、语言类型等参数。
- 接入音频数据源,实时场景推送麦克风音频流,离线场景上传本地音频文件。
- 接收接口返回文本,读取时间戳字段,开启文本规整选项获取润色后的文稿。
- 调试音频降噪、方言识别等参数,验证嘈杂场景、混合语种场景的识别效果。
- 完成测试后配置调用配额,将接口集成到软件、硬件产品,正式上线。
Spark-ASR-2.0同类产品对比
表格
| 模型 | 研发主体 | 产品定位 | 核心特色 | 适用场景 |
|---|---|---|---|---|
| Spark-ASR-2.0 | 科大讯飞 | LLM 增强语音识别模型 | 非自回归 + LLM 协同识别,高噪、快语速、中英文混说、方言识别强,识别结果自动润色成文,推理成本增幅低 | 会议转写、实时字幕、录音文稿、输入法语音输入 |
| Fun-ASR-Nano | 阿里通义百聆 | 轻量级 ASR 语音识别模型 | 小参数量,支持本地部署,中文方言、中英混合识别,推理速度快,可二次开发 | 端侧设备语音采集、轻量化语音转写、嵌入式语音交互 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...