
Index-Translate 是哔哩哔哩 Index LLM 团队推出的开源多语言翻译模型家族,依托 Qwen3.5 基座开发,提供 2B、9B、35B-A3B (preview) 多规格权重,在 Hugging Face 与 ModelScope 开放获取。整套体系覆盖 150 种语言,除基础文本互译外,配套 Index-Echo、Index-Homura、Index-NativeLong 等子模型,延伸出语音字幕、音节约束、长文档翻译能力。模型可识别网络社区语境,保留原文格式与指定术语,适配互联网 UGC 内容翻译场景,面向开发者提供完整权重与推理部署方案。
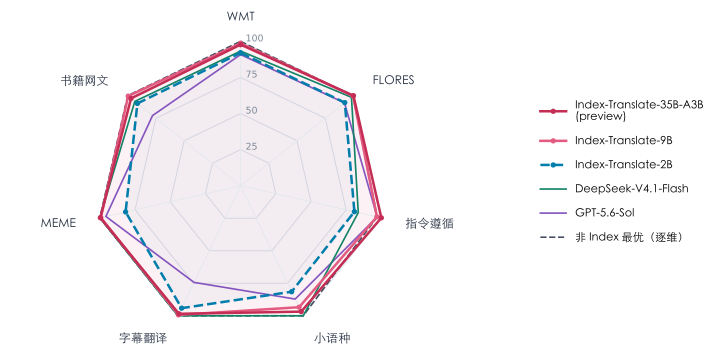
Index-Translate特点
多规格权重可选,轻量化 2B 模型适合端侧低资源设备,9B 与 35B 版本承载高难度专业翻译任务。
覆盖 150 种语种,包含大量小语种,对网络流行表达、游戏社区黑话具备语境识别能力。
接收自定义指令,锁定专有名词、固定格式,指定段落不参与翻译。
整套模型家族协同工作,文本、语音、长文档翻译任务可选用对应子模型。
权重开源,开发者可本地部署,数据不出环境,降低第三方接口调用带来的隐私风险。
Index-Translate技术原理
以Qwen3.5大模型作为基础基座,在多语言平行语料上继续微调,扩充小语种与互联网口语样本。
针对社区内容、游戏术语、结构化文本做专项对齐训练,让模型区分字面含义与场景化语义。
长文档子模型引入长上下文窗口,跨段落维持人物名称、专业术语统一。
语音分支模块完成文本与语音特征对齐,保留说话人音色特征。
音节控制分支增加音节计数约束层,输出译文匹配预设音节数量,适配字幕与配音场景。
Index-Translate功能
通用多语种文本互译,支持中英文及各类小语种双向转换。
结构化内容翻译,保留 Markdown、表格、代码标签等原有排版。
社区语境翻译,识别网络梗、游戏圈内表达,输出贴合场景的译文。
长文档连续翻译,跨章节统一术语,维持全文表达一致性。
语音字幕生成,同步产出目标语言字幕,复刻原说话人音色。
音节可控翻译,按照设定音节长度生成译文,适配视频配音需求。
Index-Translate应用场景
视频平台多语种字幕制作,海外内容本地化与国产内容对外译制。
游戏社区、二次元内容翻译,处理玩家黑话、角色对话与同人文本。
跨境文档处理,技术手册、产品说明、合同文本本地化。
开源项目本地化,软件界面、README 文档批量翻译。
多语言内容研究,小语种资料读取与跨语言信息汇总。
Index-Translate如何使用
前往 Hugging Face 或 ModelScope 平台,下载对应参数量的模型权重。
准备推理环境,安装依赖库,配置模型加载参数,选择 2B 轻量化或大参数量版本。
构造 prompt,写入翻译指令,标注需要固定保留的术语与原文格式。
输入待翻译文本,提交推理请求,获取译文结果。
长文档任务调用 Index-NativeLong 分支,分段传入内容,保证全文术语统一。
字幕配音场景切换 Index-Echo,上传音频,同步生成译文与配音音频。
本地部署完成后,可封装 API 接口,接入自有业务系统实现批量翻译。
Index-Translate同类产品对比
表格
| 项目 | Index-Translate | DeepL 翻译模型 |
|---|---|---|
| 研发主体 | IndexTeam(B 站 Index 团队) | DeepL SE |
| 产品定位 | 开源机器翻译模型,适配长文本、文档级翻译,支持本地部署 | 商用神经机器翻译系统,主打高质量通用文本翻译 |
| 核心特色 | 长上下文翻译能力强,支持保留原文排版,可本地私有化部署,中英等多语言互译效果好 | 译文流畅自然,术语一致性佳,支持文档 / 网页翻译,API 接入便捷 |
| 适用场景 | 本地私有化文档翻译、大批量长文本语料翻译、离线翻译业务 | 企业公文、商业文稿、网页实时翻译,线上翻译业务 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...