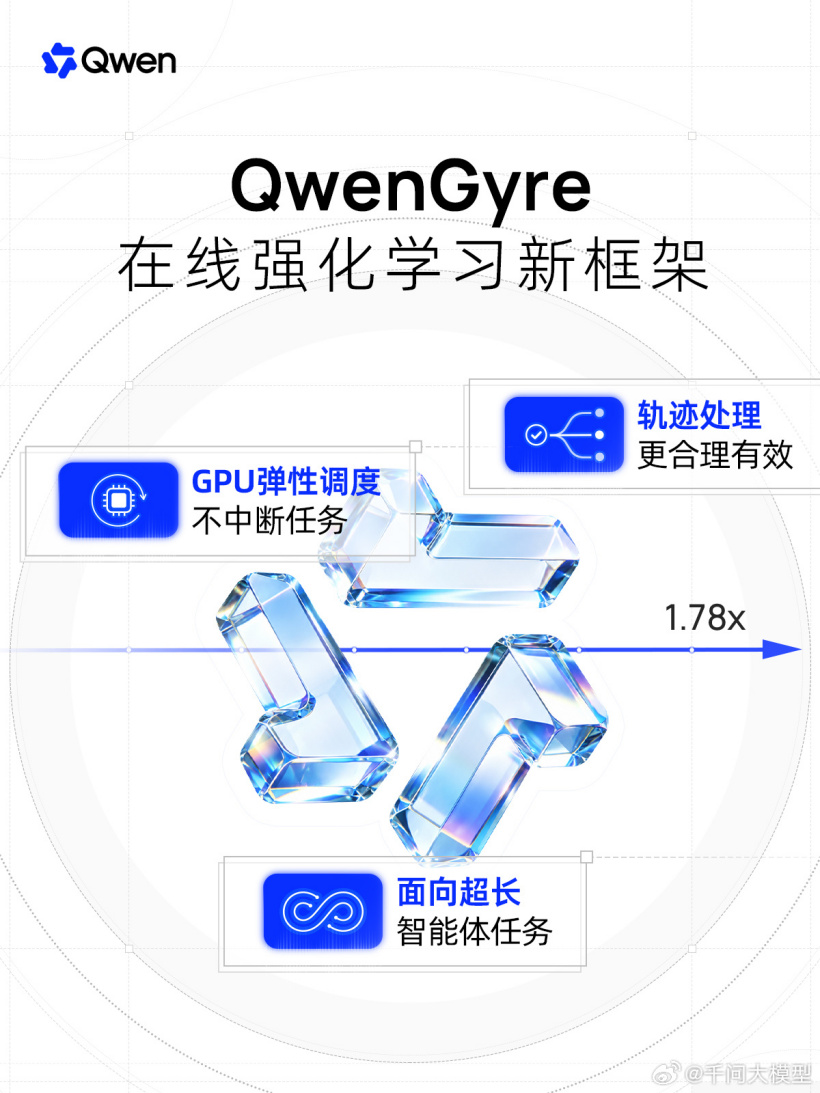
QwenGyre 是阿里巴巴通义千问团队推出,面向超长程 AI 智能体的在线强化学习框架。传统智能体训练面对持续数小时、数百轮交互、百万级 token 的任务,会出现 GPU 资源闲置、轨迹样本大量冗余等问题。这套框架依靠弹性调度与轨迹处理两大核心模块,动态分配算力资源,压缩样本重复计算开销。在 Qwen3.8 2.4T 大模型实验中,训练耗时减少 44%,任务基准通过率得到提升,可适配代码仓库开发类长时序智能体训练工作。
QwenGyre特点
支持 GPU 计算单元动态切换任务类型,智能体任务运行过程不中断,原有任务状态与缓存数据完整保留。
轨迹树存储结构压缩样本冗余内容,共享前缀内容仅执行单次计算,减少重复开销。
内置部分进度评估机制,超时未完成任务的有效执行片段,也可以生成训练反馈信号。
兼容大规模模型集群训练,可对接 Qwen 系列大模型开展长时序智能体强化学习。
训练调度模块轻量化改造,原有智能体环境改动量小,快速接入现有训练管线。
集群资源利用率维持稳定区间,减少大规模训练场景下硬件资源空转。
QwenGyre技术原理
框架拆分 GPU 集群为独立计算单元,弹性调度器持续监测智能体 rollout 任务进度,单元完成任务后,直接切换至模型参数更新环节,借助高速传输技术迁移 KV 缓存,不中断正在运行的任务。轨迹处理器记录模型每一轮输入输出,将分支执行路径构建为共享前缀的轨迹树,筛选有效分支生成训练样本。部分进度评估模块对未结束任务做阶段性打分,提取有效反馈信号送入强化学习更新流程。整套机制分离样本生成与参数更新,消除同步训练等待瓶颈,削减轨迹样本重复计算量。
QwenGyre功能
超长任务智能体强化学习训练,支撑百万级 token 交互轨迹的样本采集与模型更新。
GPU 集群弹性资源调度,自动分配算力在任务推演和模型训练两个环节之间流转。
智能体交互轨迹压缩与筛选,剔除重复内容,生成精简高效的训练数据集。
部分完成任务打分评估,提取任务中间步骤的有效反馈,提升样本利用率。
对接主流大模型推理后端,在现有智能体沙箱环境中接入训练流程。
训练指标采集,记录 GPU 利用率、样本数量、任务通过率等多维度数据。
QwenGyre应用场景
大模型研发团队开展代码智能体训练,搭建仓库级代码修改、调试类长任务智能体。
AI 基础设施实验室,针对长时序多步骤智能体开展强化学习算法对照实验。
企业自研智能体项目,构建多工具串联、跨轮次执行的自动化业务智能体。
开源社区模型迭代,提升模型在复杂工程任务、长链路工具调用场景的表现。
科研机构开展强化学习、智能体规划方向的算法研究与性能验证。
QwenGyre如何使用
1. 查阅 QwenGyre 技术文档,确认集群硬件配置,准备大模型推理与训练环境。
2. 部署弹性调度组件,接入智能体沙箱环境,完成模型推理后端对接。
3. 配置任务类型、最大交互轮次、轨迹分支数量等参数,设置部分评分规则。
4. 启动任务推演进程,智能体在沙箱内执行长周期任务,系统采集交互轨迹。
5. 调度模块将空闲 GPU 单元切换至训练环节,读取轨迹树样本,执行模型参数更新。
6. 监控训练日志,查看硬件利用率、任务完成率,调整调度与轨迹筛选参数。
7. 训练结束后导出模型权重,在评测基准验证智能体执行效果,迭代参数配置。
QwenGyre同类产品对比
表格
| 产品 | 研发主体 | 产品定位 | 核心特色 | 适用场景 |
|---|---|---|---|---|
| QwenGyre | 阿里通义千问 | 超长程智能体弹性强化学习框架 | 动态调度 GPU 算力,可在不中断 Agent 任务的前提下切换算力用于训练,对分支轨迹去重压缩,大幅降低长时序 Agent 训练开销 | 长周期代码 Agent、百万 Token 级多步交互智能体训练 |
| veRL | 字节 Seed + 社区 | 大模型强化学习开源框架 | 成熟通用 RL 训练底座,生态活跃,支持各类 LLM,适配常规单轮 / 短时序 Agent 训练任务 | 通用大模型 RL 微调、短流程智能体训练研发 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...