Ming-3.0 是蚂蚁百灵推出的开源语音模型系列,整套产品划分语音合成、长音频理解、语音识别三条分支,合计五款子模型,覆盖声音创作、录音解析、实时转写等语音类任务。系列内置导演模式,支持在文本内添加情绪标签与停顿标记,控制合成语音的语气起伏,区别于常规 TTS 的单调朗读效果。audio 分支跳过逐字转写前置环节,直接读取音频信号做内容归纳,保留对话里的情绪、说话人信息。asr 分支适配多方言、行业专业词汇识别,支持热词导入提升同音词识别准确度,模型权重托管在开源平台,配套在线体验入口与 API 调用通道,适配各类语音产品的开发接入。
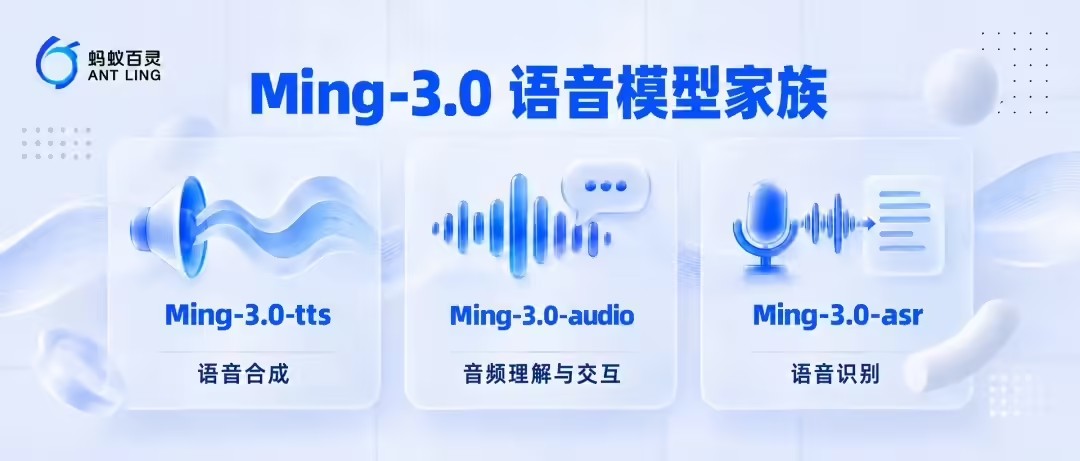
Ming-3.0特点
多子模型独立拆分,开发者按需挑选对应能力的版本组合使用。
TTS 模块搭载导演模式,副语言标签可嵌入文本,调节语速、停顿、情绪强弱。
audio 分支原生处理长音频,不依赖中间文本结果,保留音频自带的非语言信息。
asr 分支支持热词列表注入,方言与专业场景识别效果得到强化。
全部权重对外开源,本地部署与云端 API 两种调用路径都开放。
模型之间可以串联,识别结果直接送入音频理解或语音合成链路。
Ming-3.0技术原理
TTS 分支采用时序扩散架构,文本标签映射为韵律特征向量,驱动声学模块生成贴合情绪的语音波形。
audio 分支使用低帧率音频表征方案,搭配混合注意力机制压缩长序列算力开销,直接从音频频谱提取语义、情绪、说话人特征。
asr 分支融合声学编码器与语言基座,上下文缓存模块读取上文信息校正同音候选,
热词模块单独构建检索空间,优先匹配自定义词条。
整套系列采用统一音频预处理管线,不同子模型共享前端信号处理逻辑,降低多模型串联时的适配成本。
Ming-3.0功能
文本转语音合成,支持情绪、停顿、语气标记自定义,产出自然人声音频
。长音频内容解析,读取录音文件输出摘要、观点归类、说话人划分结果。
实时与离线语音识别,覆盖普通话、多种方言、英文,导入热词提升识别精度。
音频内容结构化整理,区分多轮对话角色,提取关键信息生成格式化文本。
模型串联调度,识别输出内容直接送入 TTS,搭建语音对话链路。
本地离线推理部署,轻量化版本适配端侧设备运行。
Ming-3.0应用场景
有声读物、短视频旁白、角色台词类语音素材制作。客服通话、会议录音、访谈音频批量归档与内容复盘。
方言场景的语音采集、实时字幕、语音交互产品开发。
医疗、金融等垂直业务的语音核身、语音助手交互。
语音算法研发人员开展 TTS、音频理解、ASR 方向对照实验。
智能硬件搭载语音交互模块,搭建本地语音应答系统。
Ming-3.0如何使用
前往 HuggingFace 或 ModelScope 仓库下载 Ming-3.0 对应子模型权重。
配置音频处理依赖库,安装推理所需的 Python 环境。选定子模型,TTS 任务准备带情绪标签的文本,ASR 任务准备热词文档。
传入音频或者文本素材,调整采样率、语速、情绪强度参数。
发起推理请求,获取合成音频或者结构化识别、摘要结果。
测试多轮串联流程,把识别输出送入 TTS 模块完成语音回复。
根据设备算力选择大版本或者 tiny 轻量化版本,调整批处理参数优化吞吐。
Ming-3.0同类产品对比
表格
| 项目 | Ming-3.0(蚂蚁百灵) | MiniMax Speech 系列 |
|---|---|---|
| 开发方 | 蚂蚁百灵 | MiniMax |
| 产品类型 | 语音全栈模型(TTS+ASR + 长音频理解) | 语音合成、音频理解模型 |
| 核心亮点 | TTS 支持导演模式,精细控制情绪、副语言;ASR 方言热词识别强;原生长音频转写 & 摘要分析,面向 VoiceAgent | 音色自然度高,支持多风格、多人声;音频理解能力成熟,API 生态完善 |
| 适用场景 | 企业语音中台、客服录音分析、情感台词合成、方言业务识别 | 有声内容、直播配音、音频对话、C 端语音交互 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...