DeepInfer 是 DeepSeek 对外开源的生产级大模型推理框架,源自内部线上服务系统,面向 MoE 架构大模型做底层调度优化,配套同步开放自研 token 编解码组件。框架兼容英伟达 GPU 与昇腾 NPU 硬件,适配 DeepSeek 全系模型权重,长上下文、批量并发、多专家路由场景下的调度逻辑经过线上业务验证,开源协议采用 Apache2.0,企业和开发者可基于源码修改、部署,用来搭建稳定的大模型在线服务集群,缓解大规模部署时的显存占用、延迟波动与集群吞吐瓶颈。
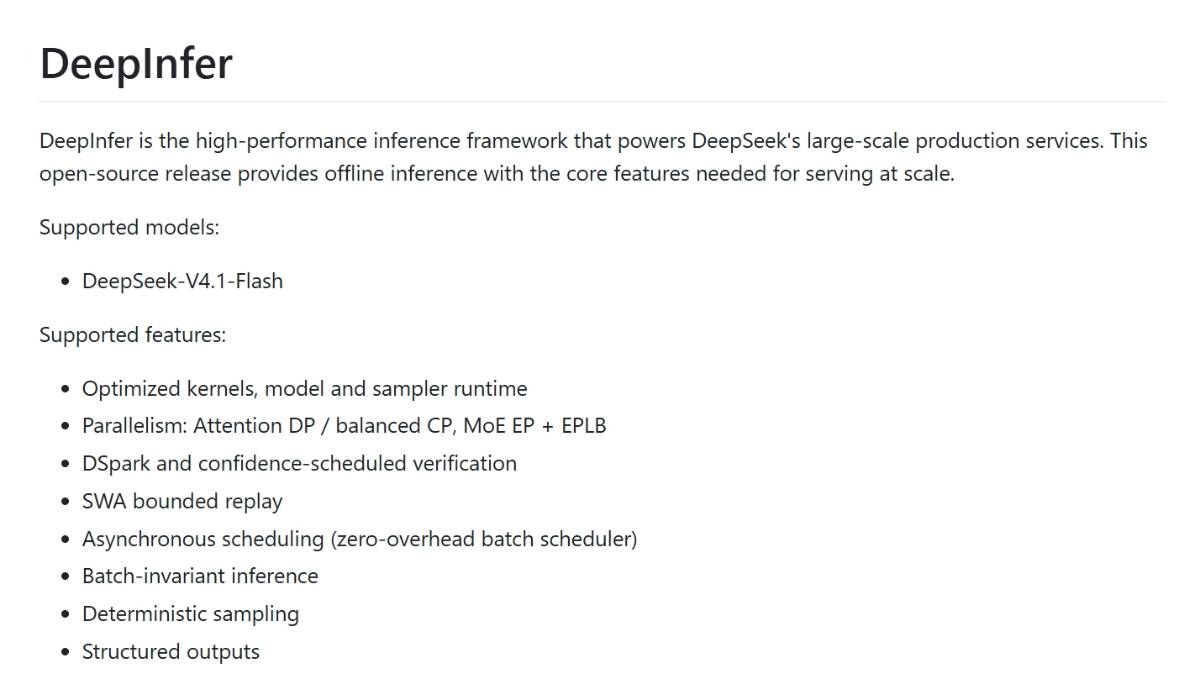
DeepInfer特点
原生适配 MoE 类大模型,内置专家路由负载均衡逻辑。
零开销异步调度机制,请求排队阶段减少空闲算力浪费。
置信度驱动推测解码,减少无效计算步骤。
滑动窗口缓存回放策略,控制长序列场景下 KV 缓存的内存增长。
支持多卡分布式推理,单集群可承载海量 token 吞吐。
兼容主流量化方案,FP4、FP8 权重均可接入运行。
对外提供标准化服务接口,可对接现有模型网关与监控组件。
DeepInfer技术原理
底层围绕批次无关推理机制构建调度核心,把不同长度、不同优先级的请求打散重组,消除长请求阻塞短请求带来的抖动。
推测解码模块会提前生成候选 token 序列,用主模型校验结果,过滤偏差内容。
MoE 路由模块加入负载感知逻辑,动态调整专家分配比例,避免部分专家过载。
KV 缓存使用分段回收机制,过期片段释放显存资源。
调度单元和计算单元异步分离,调度任务不抢占算力核心,硬件资源持续保持高利用率。
DeepInfer项目地址
- GitHub仓库:
- https://github.com/deepseek-ai/DeepInfer
- https://github.com/deepseek-ai/deepseek-recipe
DeepInfer功能
加载各类大模型权重并启动推理服务,管理多并发请求队列。
执行 KV 缓存管理,控制显存占用上限。
分发 MoE 专家任务,完成多卡之间的数据通信。
接入推测解码逻辑,压缩生成等待时长。
输出兼容 OpenAI 格式接口,便于业务侧直接接入。
采集推理指标,记录单请求耗时、显存占用、专家访问频次。支持权重热切换,更新模型版本不用关停整套服务。
DeepInfer应用场景
AI 服务商搭建公有大模型 API 集群,承接高并发用户请求。
企业私有化部署 MoE 大模型,搭建内部知识库、代码助手服务。
科研团队做模型性能对照测试,对比不同调度策略的吞吐数据。
AI 开发平台接入底层推理能力,给上层应用提供稳定算力支撑。离线批量任务处理,大规模文档转写、数据集标注推理任务。
DeepInfer如何使用
拉取 DeepInfer 开源仓库代码,按照文档安装依赖组件。
准备目标模型权重,转换为框架适配的存储格式。
编写服务配置文件,填写硬件类型、卡数量、缓存上限、端口参数。
启动推理服务进程,等待权重加载完成。
通过标准接口发送文本请求,获取模型返回内容。
查看日志输出的运行指标,调整调度参数优化延迟与吞吐。采集线上异常请求样本,对照参数配置做二次调优。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...