Eleven Realtime 是 ElevenLabs 推出的端到端语音对语音模型系列,包含 v1Mini 与 v1Max 两个版本,把语音信号检测、说话轮次判断、语言逻辑处理、语音合成整合为一套完整系统。开发者不用分别选型、调试多套独立组件,选定对应模型版本即可搭建语音交互智能体。整套体系兼容九十种以上语言,可调用平台内置一万七千余款音色资源,API 层面适配 OpenAI Realtime 接口规范,已有相关业务代码仅修改接口地址与模型标识就完成接入。v1Max 侧重复杂多步骤任务,v1Mini 面向轻量化对话场景,两者均采用 WebSocket 链路传输音频流,维持亚秒级的应答反馈。
Eleven Realtime特点
端到端语音流转,输入原始音频流直接输出语音音频,无需手动串联识别与合成模块。
原生处理对话打断、停顿判断、语气附和等真实交谈行为,还原真人对话节奏。
双版本梯度划分,按需切换 Mini 与 Max,业务底层集成逻辑不用改动。
音色库完整复用,全部平台已有声音样本都可以绑定给语音智能体使用。
接口协议对齐 OpenAI Realtime,原有 SDK 代码可直接复用。
依托 ElevenAgents 平台,可对接电话、网页、消息软件等多类对外渠道。
Eleven Realtime技术原理
摒弃传统级联式管线,不输出中间文本转录结果,音频信号直接送入统一模型主干。模型内部划分音频编码层、对话状态判别层、推理生成层、语音解码层,音频流以分片形式持续流转。对话状态判别层持续解析用户停顿、插话、语气反馈信号,调整输出节奏。v1Max 内置更强工具调用分支,解析任务指令后向外下发工具请求,结果回流至生成链路。整套服务运行在 WebSocket 长连接之上,音频分片持续双向推送,把整体应答时延压缩至亚秒区间。
Eleven Realtime功能
实时双向语音对话,接收麦克风音频流,直接返回合成语音音频流。
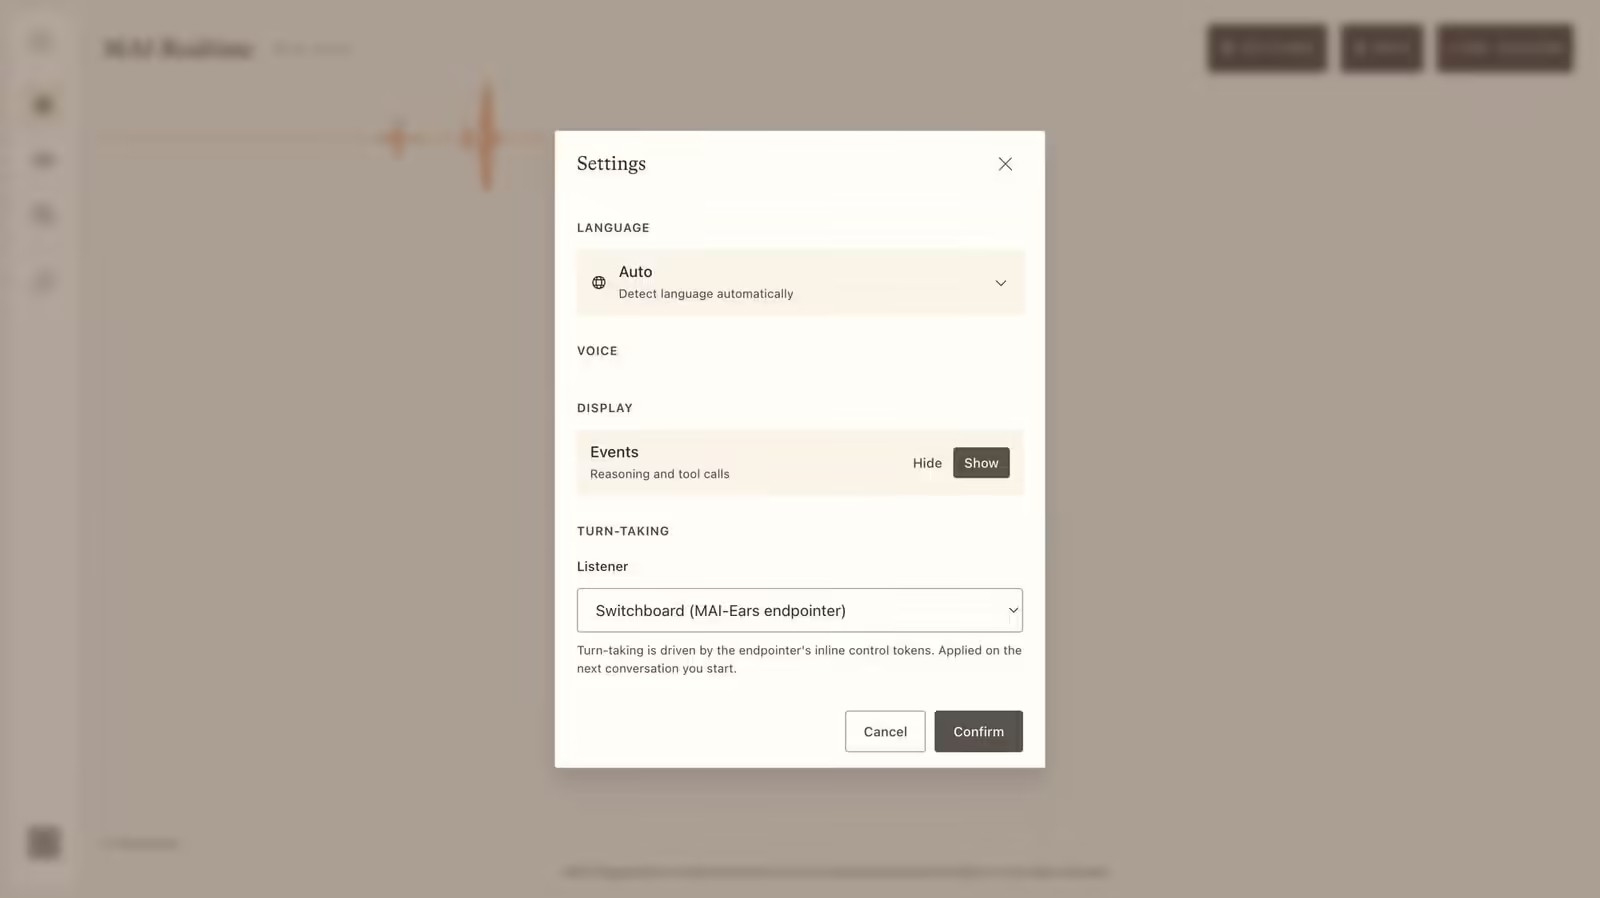
交谈行为处理,识别用户打断、短暂停顿,动态暂停或者恢复语音输出。
外部工具调用,接收业务流程指令,调取外部数据完成多步骤任务。
多语种交互,切换不同语种,匹配对应音色输出语音回复。
自定义系统提示,设定语音智能体身份、对话风格、应答约束条件。
对接多发布渠道,把语音能力部署到电话、网页会话、消息应用入口。
Eleven Realtime项目地址
- 项目官网:https://elevenlabs.io/blog/realtime
Eleven Realtime应用场景
线上客服系统,处理用户来电咨询,执行信息收集与业务查询流程。
虚拟教学辅导,搭建口语练习类语音交互产品,完成实时问答互动。
游戏互动角色,游戏内实时语音 NPC,响应用户口头指令。
智能语音助手,面向 C 端产品搭建低开销语音对话模块。
线索信息筛选,通过语音对话采集用户资料,完成信息分类归档。
语音算法产品原型,快速验证全双工语音智能体产品构想。
Eleven Realtime如何使用
登录 ElevenLabs 平台,完成账号注册,获取 API 访问密钥。2
两种接入路径可选,使用 ElevenAgents 可视化平台,或是调用 RealtimeAPI 接口。
使用 ElevenAgents 时新建 Agent 项目,在模型下拉菜单选定 v1Mini 或者 v1Max,挑选音色,填写系统提示,配置知识库、工作流、防护规则。
API 接入准备 WebSocket 客户端,修改现有 OpenAI Realtime 代码,替换服务端地址与 model 字段。
配置输出媒介、音色参数,建立长连接,推送麦克风采集的音频分片。
接收服务端回传的音频流,播放语音,监听对话事件,处理打断与工具回调。
开展功能测试,确认时延、对话轮次、工具调用逻辑无误,再上线业务渠道。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...