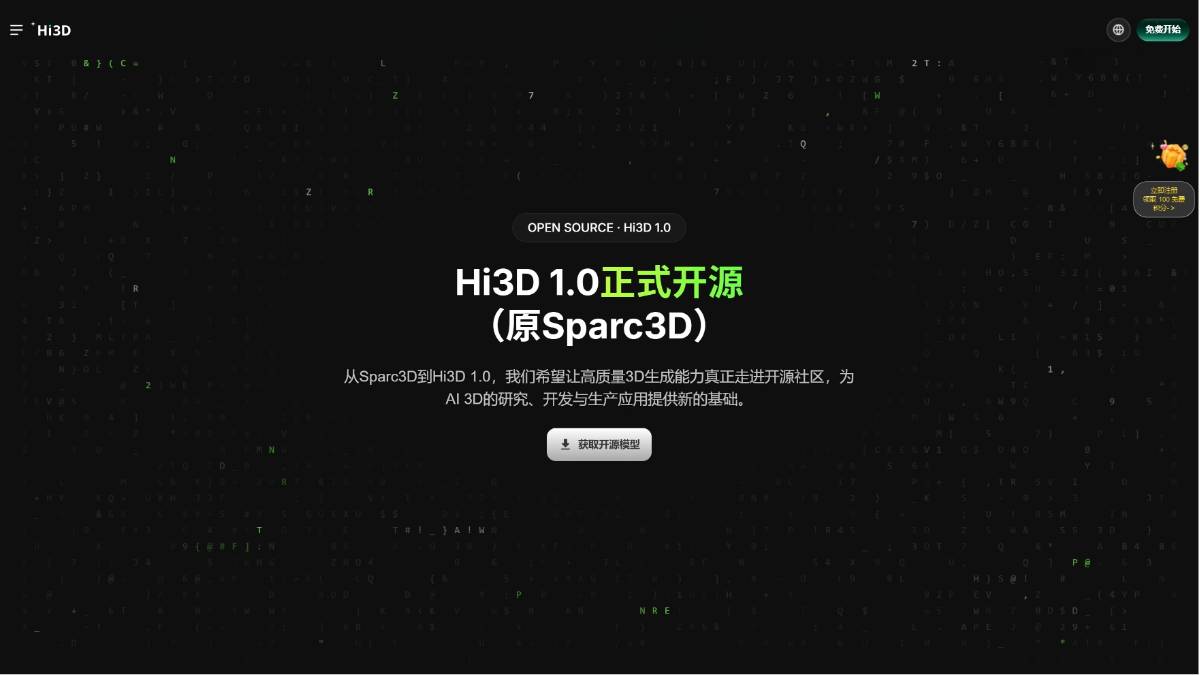
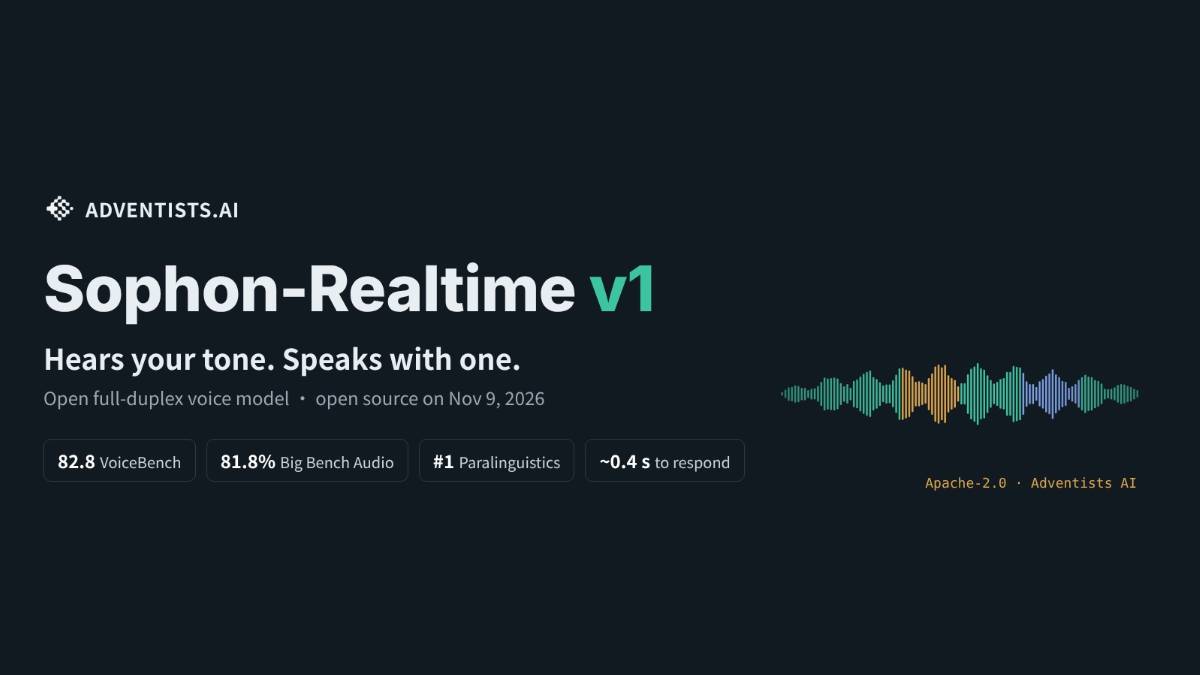
Sophon-Realtime v1是Adventists AI推出的开源全双工实时语音模型家族,2026年11月开放全部代码与权重,采用Apache-2.0协议,支持商业免费使用。全系列共享32B参数的核心推理模型,分化出Tag、Flash、E2E三个侧重不同的版本,单张80GB显卡即可部署运行。模型主打副语言理解与情感化语音输出,可识别用户语气、情绪与非语言信号,对话中自然加入笑声、叹息、停顿等表现,支持打断插话、边听边生成的流式交互,还原真人级对话体验。
Sophon-Realtime v1特点
开源全双工语音能力处于同赛道第一梯队。在Voice Bench、BigBench Audio两项主流评测中,模型得分在开源全双工模型里排名首位,整体表现与GPT-4o-mini-Audio持平。副语言理解综合得分48.6.领先同类主流模型,可精准识别语音中的情绪、重音、讽刺、笑声与叹息等信号。
三个版本适配不同需求场景。Tag版本主打表现力,语音情感与非语言音效最自然,适合陪伴型、角色型对话场景。Flash版本主打速度与并发,首音延迟低至0.31秒,单卡可承载更多用户,适合大规模客服、车载等场景。E2E版本为预览形态,采用端到端语音架构,面向前沿研究场景。
部署门槛低且并发能力强。Tag与Flash版本都依托vLLM-Omni部署,单张80GB显卡分别可承载16路与40路并发对话。用户通过一行命令即可启动服务,不需要复杂的环境配置与组件拼接,落地成本远低于同类闭源方案。
多语言覆盖范围广。原生支持中文与英语,可流畅完成多轮对话。意大利语、德语、西班牙语、法语、葡萄牙语也已达到可用状态,Flash版本额外支持日语与俄语,后续还会持续扩充语言种类。
Sophon-Realtime v1技术原理
整个模型家族采用“统一大脑+差异化语音输出”的架构设计。核心推理层是32B参数的语言模型,负责语音识别、语义理解、回复生成与情感决策,三个版本共享这部分能力。差异集中在语音合成环节,Tag与Flash搭配不同规格的表现力语音模型,E2E版本则将语音生成内置到核心模型内部。
全双工交互依赖持续监听与预判生成机制。模型全程保持收音状态,每出现一次停顿就会判断用户是说完了、还在表达、只是插话间隙还是在思考。用户开口的第一时间就开始生成回复草稿,判定轮到自己发言时立刻输出语音。用户中途打断的话,草稿直接丢弃,只保留对方已听到的内容进入对话历史,不会出现强行说完的情况。
副语言能力分为理解与表达两端。输入端依托DuplexJev语音决策模型,单次前向传播就能完成端点检测、打断识别、情绪判断、重音识别等所有语音决策,延迟控制在百毫秒以内。输出端由核心模型生成带声音标签的文本,标注哪里该笑、该叹气、该停顿或者加重语气,再由语音模型转化为自然的人声,不会把标签直接念出来。
Live模式通过网关层实现协议兼容。网关对接前端的GPT-Live协议请求,将语音交互转发给核心模型处理,再把结果按对应格式返回。原有适配OpenAI实时语音接口的客户端,只需要更换接口地址与密钥就能切换使用,不需要做大量改造。
Sophon-Realtime v1项目地址
- GitHub仓库:https://github.com/adventists-ai/sophon-realtime
Sophon-Realtime v1功能
全双工流式对话。模型可以边听边处理,用户随时可以插话打断,模型会立刻停止输出并响应新的内容,不需要等整句话说完再交互,对话节奏和真人交流一致。
副语言感知与表达。输入端可以识别用户的情绪变化、语气轻重、笑声叹息等信号,理解话语之外的情感倾向。输出端会根据对话语境自动加入笑声、叹息、呼吸、清嗓等非语言音效,语气重音也会对应调整,对话更有真实感。
零样本声音克隆。Flash版本支持通过3到10秒的参考音频实现零样本声音复刻,用户上传一段语音就能生成对应音色的对话内容,适配定制化语音形象的需求。
工具调用与任务执行。支持语音触发工具调用,全双工工具调用基准测试中通过率达到48%,响应率为百分之百。用户可以直接用语音指令完成信息查询、操作执行等任务,不需要切换到文本交互。
Live模式后端联动。可以对接更大的后端模型处理复杂业务逻辑,自身负责前端的语音交互与对话衔接。这套模式兼容GPT-Live接口,原有实时语音应用可以快速切换接入,复用已有业务逻辑。
低成本微调支持。支持通过LoRA方式微调核心模型,定制人设、语气风格、领域知识与工具调用能力,微调过程只需要单张80GB显卡。微调不会破坏原有的语音表现力、声音标签与话轮切换能力,适配行业定制需求。
Sophon-Realtime v1应用场景
智能陪伴与虚拟角色。可以用来打造情感陪伴型语音助手、虚拟角色对话产品,丰富的语气与非语言音效让交互更有温度,适配AI陪伴、角色对话、故事互动等产品形态。
智能客服与呼叫中心。Flash版本的高并发与低延迟特性,刚好匹配客服场景的大规模接入需求。全双工交互让对话更自然,工具调用能力可以直接对接业务系统处理查询、办理类工单,提升客服处理效率。
车载语音交互。低延迟、可打断的特性适配车载场景的安全交互需求,驾驶员不用等系统说完就可以补充指令,操作更流畅。多语言支持也能适配不同地区的车载系统需求。
数字人与直播互动。结合数字人形象可以打造实时互动的虚拟主播、虚拟讲解员,自然的语气与情感表达让播报更生动,也可以承接观众的实时语音提问与互动。
教育与语言学习。可以作为口语练习的对话伙伴,实时纠正发音、引导对话,自然的交互节奏贴近真人外教的交流体验,多语言支持也能覆盖不同语种的学习需求。
企业内部语音助手。部署在企业内部对接业务系统,员工可以通过语音查询数据、发起流程、处理办公事务,全双工交互让办公操作更高效,定制微调能力可以适配企业专属的业务知识。
Sophon-Realtime v1同类产品对比
表格
| 项目 | Sophon-Realtime v1 | Qwen3-Omni |
|---|---|---|
| 开发方 | Adventists AI(开源,Hugging Face / 魔搭 “智子”) | 阿里通义 |
| 产品类型 | 开源全双工实时语音对话模型 | 全模态端到端模型(含实时语音交互) |
| 核心亮点 | 真正做到 “边听边说”:对方说话时持续听,一停顿立即接话,被打断即刻收声;还能听出犹豫、语气与情绪,副语言基准 48.6 分,高于 Gemini 3.8 Flash(46.9)与 Qwen3-Omni(44.6);开源可自部署 | 文本、图像、音频统一建模,语音生成自然度高,多语言与跨模态理解均衡,生态工具与推理部署方案成熟 |
| 适用场景 | 实时语音助手、AI 客服外呼、陪聊 / 情感陪伴、口语陪练、端侧低延迟对话 | 多模态助手、语音播报、跨模态问答、企业级全模态应用集成 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...