过去跟AI视频助手说话,节奏是死的:你说完,它停一拍,再答;它说话时你插不上嘴。真人聊天不是这样——会打断、会沉默、会在你停顿的间隙接话。蚂蚁技术研究院与西湖心辰共同发布Duo v1.这是双向世界模型(Reciprocal World Model,RWM)的首个实现。它持续接收用户的音频、视频与文本输入,自己决定什么时候开口、什么时候听,并生成与之匹配的视听画面和声音,原生支持全双工、实时、双向交互。模型能主动插话、能被随时打断,还能隔着屏幕接住你递过去的真实物体。
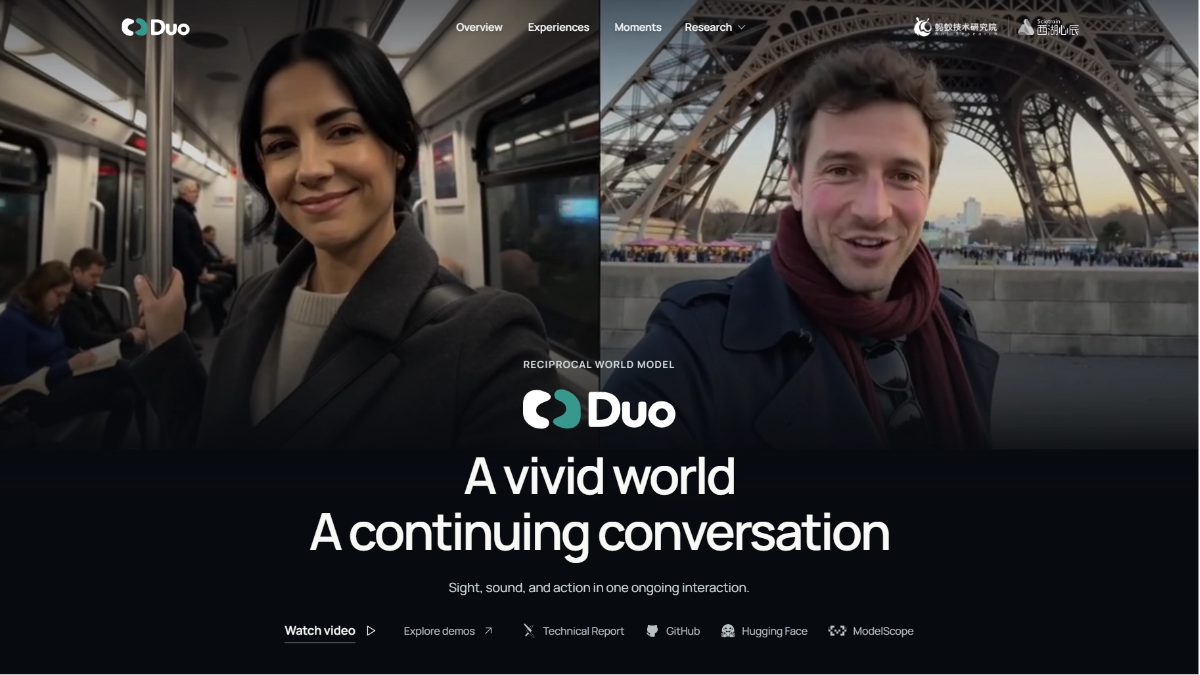
Duo v1特点
智能主体是世界的一部分,不是外挂。 现有世界模型大多只在做物理环境的仿真,把推理和决策当成从外部伸进来的控制器。RWM把智能与物理现实放在同等基本的位置:Intent负责交互背后的认知与参与决策,Realization负责生成连贯的视听行为,两者内生耦合,虚拟主体第一次成为世界模型的内部构成,而不是被脚本操控的对象。
它自己判断要不要说话。 Duo v1把自回归建模用在连续的交互推理与参与决策上,而不是只把它当成给扩散模型念指令的模块。模型在每一段输入上都要做”现在该我开口,还是继续听”的判断,沉默和插话都成了生成过程的一部分。
打断是原生能力。 两个模块都持续感知实时音、视频与文本, spontaneous对话和打断不需要额外的工程逻辑去拼接,听与说在同一条时间线上推进。
能跨真实与生成两个世界做动作。 主页的演示展示了”递一杯饮料””一起玩游戏””改变场景”这类跨世界动作——用户把实物展示给镜头,模型能就着画面继续互动,操作不依赖鼠标和键盘。
实时与离线两条链路。 演示分成causal-dmd(实时因果)与bi-direction(离线双向)两种,前者面向真实时延场景,后者质量上限更高,对应不同的应用形态。
Duo v1项目地址
- 项目官网:https://duo-v1.github.io/
- GitHub仓库:https://github.com/inclusionAI/Duo
Duo v1优势
解决了”过度等待”这个全双工老毛病
训练Intent模块时用了目标采样重平衡,专门纠正模型倾向于一直等用户说完、不敢主动开口的偏差,让抢话和接话的时机更接近真人。
训练与推理行为对齐
Realization训练时用专门的注意力掩码,每个块的因果依赖在块内与跨块都受约束,模型在训练阶段就只能看到推理时能看到的东西,不会偷偷访问未来输入,避免了训练用录制媒体、推理用自身生成结果时的分布错位。
双重滚动蒸馏消除分布漂移
训练阶段喂的是真实录制的视听历史,上线后模型吃的却是自己合成的历史,这条裂缝会让误差越滚越大。Dual Rollout让冻结的Intent生成文本、Realization基于自身合成的视听历史继续训练,把推理分布提前对齐进训练。
推理成本被压到4步
第三阶段用分布匹配蒸馏把生成器压缩到4步,这是它能跑实时链路的关键工程手段之一。
统一时间线同步两个模块
通过为每个块构造专属条件,把Intent与Realization的token同步到同一条时间线上,模块专属的注意力掩码分别控制两个模块的可见范围,耦合是结构层面的,不是后处理拼出来的。
评测口径贴着真实交互
主页展示了Overtime cat、Anime girl、Golden retriever、Panda、Seaside conversation等实时与离线演示,并放出训练数据里的真实交流片段(园艺建议、围绕材料做设计、计划修改、跨距离守约、歌剧双视角等),训练数据的构成在技术报告的数据章节有说明。
Duo v1功能
Duo v1应用场景
虚拟陪伴与数字人
能主动接话、能被打断、有沉默节奏的虚拟角色,比回合制的数字人播报更接近真人相处,主页的训练数据样本就覆盖陪伴、共同规划、日常指导这几类。
实时互动娱乐与内容
观众隔着屏幕向角色递东西、一起玩游戏、用一句话改变场景,这类玩法不需要任何外设,交互通道就是摄像头和麦克风。
教育、导购与咨询类交互
讲解过程中需要看图判断对方是否跟上、随时被打断追问、边演示边解释的场景,对全双工能力的依赖最重。
具身与XR的虚拟主体
当智能主体本身是世界模型内部的一部分,而不是外挂的控制器,虚拟角色在生成的空间里就有了自己的感知与表达闭环,适合做交互式虚拟世界的NPC底座。
研究与方法参考
三阶段训练配方、因果注意力掩码设计、Dual Rollout蒸馏这套做法,对做全双工语音、流式音视频生成、世界模型的团队都有直接参考价值。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...