
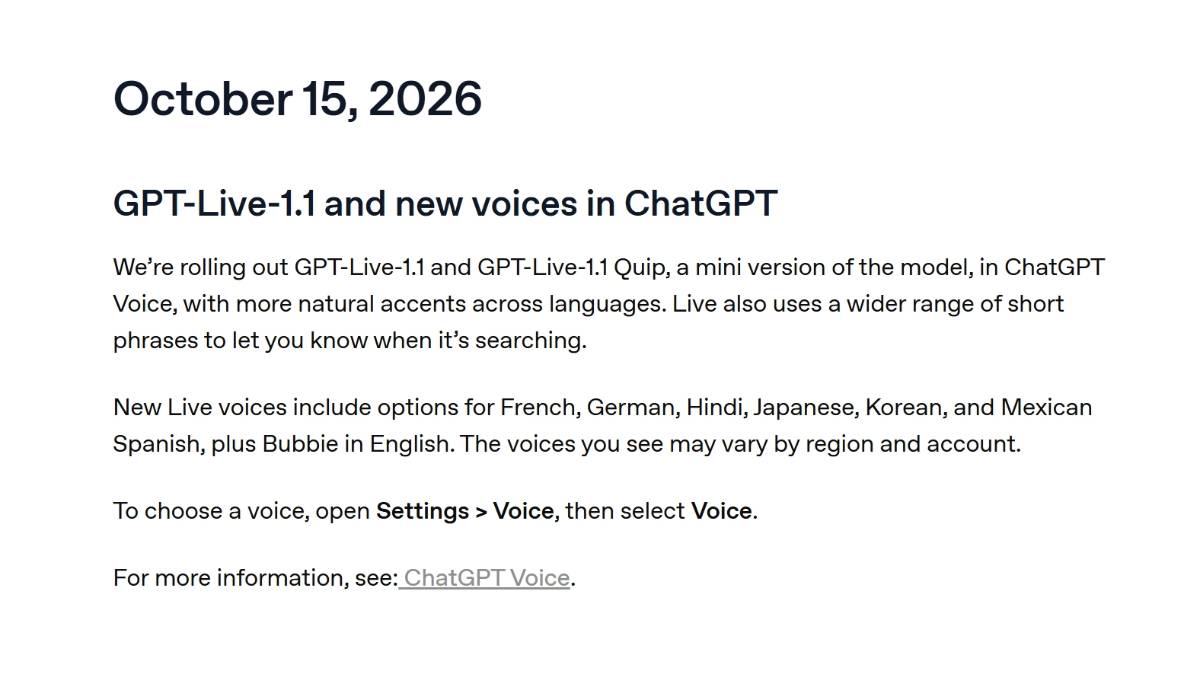
GPT-Live-1.1是OpenAI推出的迭代版实时语音模型,搭载全双工交互架构,支持同步收音与语音输出,摆脱传统一问一答的轮次限制。模型底层依托GPT-5.5系列主干能力,支持文本、图像多模态输入,内置网页检索与记忆模块,对话过程中接收用户打断、停顿信号,动态调整输出节奏。音频链路去除独立轮次检测器,压缩端到端延迟,可同步输出语音与流式文本,配套可视化组件展示结果,适配移动端与网页端语音对话场景,复杂任务可将推理需求转交主干模型完成计算。
GPT-Live-1.1特点
全双工音频链路,同步执行收音与语音生成,识别对话内打断、停顿信号。
低延迟流式输出,音频与文字同步推送,减少等待时长。
多模态输入兼容,语音对话中接收图片内容,结合图像信息给出回复。
工具调用支持,对话流程内触发网页检索,调取历史记忆信息。
任务委派机制,复杂推理任务转交底层主干模型处理,维持对话连贯性。
多终端适配,网页端、iOS、安卓客户端均可加载运行。
GPT-Live-1.1技术原理
全双工架构持续对流式音频信号编码,不再等待用户说完整段内容才启动处理。音频编码器将采集的语音转为序列向量送入主干网络,模型每秒多次判断交互状态,选择继续聆听、开口回复或是暂停输出。轻量语音处理模块负责基础对话,遇到高复杂度逻辑任务时,将任务委派至 GPT-5.5 主干模型执行,结果回传给语音模块完成语音合成。记忆与检索模块作为独立支路并行运行,提取对话信息并检索外部资料,内容合并后进入生成链路。安全校验嵌入音频流,边交互边检测输入输出内容,实时调整对话走向。
## 功能
实时语音对话,模拟自然交谈,接收中途打断,适配自由交谈模式。
语音 + 图文混合交互,上传图片搭配语音提问,解析画面信息。
联网资料检索,对话过程调取网络信息,输出时效性内容。
对话记忆存储,留存历史对话信息,跨会话保留交互细节。
多语言实时翻译,语音输入直接转换目标语种语音输出。
流式文本同步,语音播放同时展示对应文字内容。
GPT-Live-1.1应用场景
个人语音助手,日常问答、头脑风暴、语音方案讨论。
实时口译服务,跨语种面对面沟通、线上会议同声转译。
语音客服系统,搭建可被打断的交互式语音接待服务。
教育语音辅导,口语练习、知识点问答,模拟真人对话练习。
多模态交互产品研发,移动端语音产品原型开发与测试。
GPT-Live-1.1如何使用
1. 登录 ChatGPT 网页端或是移动端 App,进入对话界面开启语音模式,切换选择 GPT-Live-1.1.
2. 确认麦克风权限开启,允许设备采集音频,检查网络链路保障低延迟传输。
3. 直接以语音形式发起提问,交谈过程可随时打断模型输出,发起新问题。
4. 上传图片文件,搭配语音指令,提交图文结合类任务。
5. 开启网页搜索开关,模型在对话中调取线上资料,查看附带的检索引用。
6. 查看同步展示的流式文本,核对语音输出内容,调整语音音色参数。
7. 完成测试后,可等待 API 开放,将这套实时语音能力接入自研应用。
GPT-Live-1.1同类产品对比
表格
| 项目 | GPT-Live-1.1 | Gemini 3.8 Live |
|---|---|---|
| 开发方 | OpenAI | |
| 产品类型 | 全双工实时语音对话模型 | 原生实时多模态语音交互模型 |
| 核心亮点 | 支持对话打断、边听边说,多语种口音优化,可联动搜索、图像、Agent 工具,对话临场感强 | 支持音视频 + 屏幕流实时输入,多模态同步理解,端侧低延迟,原生支持实时画面解读 |
| 适用场景 | 手机 / 网页端自然语音聊天、口语练习、语音智能助手开发 | 视频通话式实时交互、直播画面分析、远程多模态智能体 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...