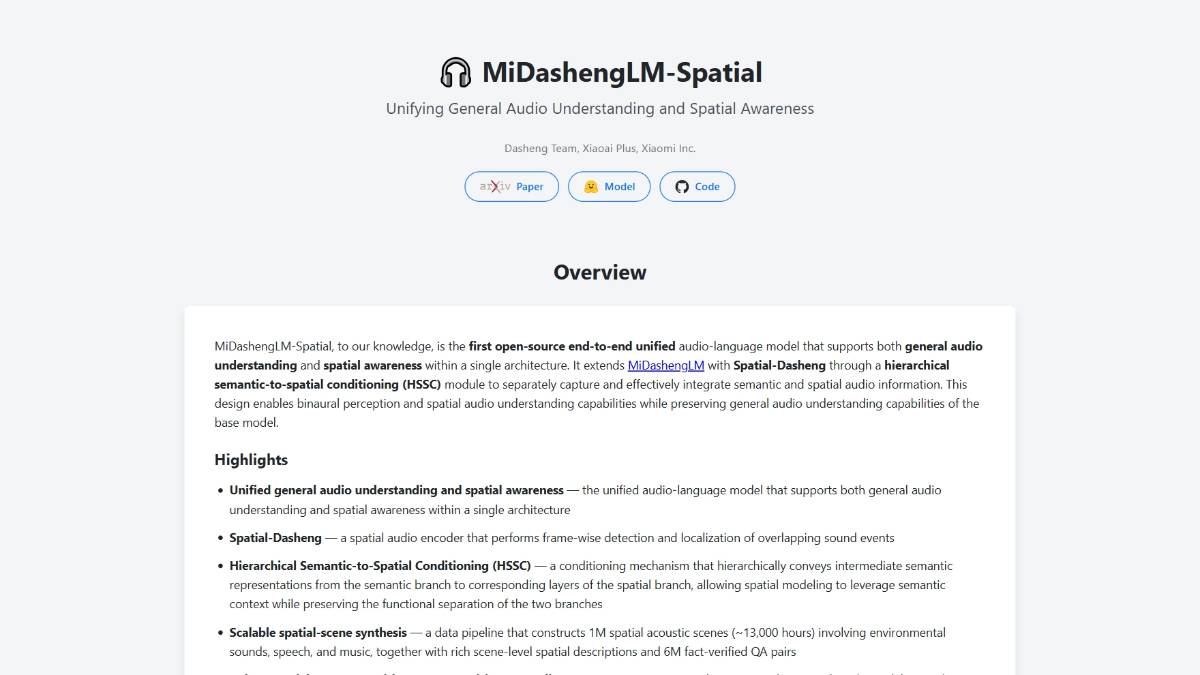
MiDashengLM-Spatial是小米推出的开源端到端空间音频语言模型,在MiDashengLM-7B基础上扩展双耳空间感知能力,单模型同时承载通用音频理解与声源空间推理能力。现有音频大模型大多将多声道音频转为单声道处理,声道间空间线索直接丢失,专门的空间音频模型又缺少通用音频解析能力。这套模型采用双分支音频编码器架构,新增Spatial-Dasheng空间编码器,搭配分层语义到空间特征注入模块,可识别重叠声源,判断声源方位、距离与移动轨迹,代码与模型权重对外释放,适配双耳录音场景下的音频内容解析任务。
MiDashengLM-Spatial特点
双分支音频编码结构,语义分支与空间分支独立运行又互相传递特征信息。
保留原有MiDashengLM通用音频识别能力,新增声源空间位置感知。
支持多声源重叠场景解析,区分不同声源对应的位置信息与运动状态。
合成大规模双耳音频数据集完成训练,适配真实室内声学环境。
开源权重与代码,遵循 Apache2.0 协议,可直接用于研究与商用开发。
单模型完成音频内容识别与空间推理,不用串联多个独立模型。
MiDashengLM-Spatial技术原理
双分支编码器包含语义分支Dasheng-Huge与空间分支Spatial-Dasheng。语义分支提取音频内容、音色、事件类别等信息,空间分支提取声道间相位、响度差等空间声学线索。分层语义到空间特征注入模块,在网络多层级把语义特征传递到空间分支,让空间建模环节同步获取音频内容信息。训练阶段使用头相关传递函数模拟各类声学环境,生成百万级双耳音频样本与空间问答数据,学习声源方向、距离、运动轨迹映射关系。音频特征经过映射层接入大语言解码器,将音频语义与空间信息转换为文本描述。
MiDashengLM-Spatial项目地址
- 项目官网:https://jinbo-hu.github.io/midashenglm-spatial-demo/
- GitHub仓库:https://github.com/xiaomi-research/midashenglm-spatial
MiDashengLM-Spatial功能
声源定位检测,识别场景内多个声音事件,输出声源方向与距离。
音频场景描述,解析双耳录音,输出环境、人声、音乐对应的文本说明。
声源运动推理,追踪移动声源,描述声源靠近、远离、平移等动态变化。
多声源区分,重叠发声场景下,拆分不同声源对应的类别与空间位置。
空间问答交互,针对双耳音频素材,回答声源相关空间类提问。
音频事件分类,识别语音、环境噪声、乐器声等各类声音类别。
MiDashengLM-Spatial应用场景
空间音频内容分析,处理 VR、AR 设备采集的双耳音频,解析场景声学信息。
智能音频监测,室内多声源定位,识别异常声音发生位置。
音频算法研究,空间音频语言模型、声源定位方向的对照实验。
耳机音频交互产品研发,基于双耳收音实现声源方位感知交互。
多媒体内容制作,空间音轨标注,自动生成空间场景文本描述。
MiDashengLM-Spatial如何使用
1. 访问小米研究MiDashengLM项目页面,下载MiDashengLM-Spatial模型权重与开源代码。
2. 搭建深度学习运行环境,安装音频处理、模型推理相关依赖库。
3. 准备双耳音频素材,音频采样率调整至模型支持规格,输入双声道音频文件。
4. 加载双分支编码器与大语言解码器,启用分层语义到空间特征注入模块。
5. 送入双耳音频,启动推理,获取声音事件、声源方位、运动状态文本结果。
6. 校验多声源识别效果,调整推理参数,降低重叠声源识别误差。
7. 验证效果稳定后,封装推理接口,接入自研音频处理系统。
MiDashengLM-Spatial同类产品对比
表格
| 项目 | MiDashengLM-Spatial | Qwen3-Omni |
|---|---|---|
| 开发方 | 小米 | 阿里通义千问 |
| 产品类型 | 开源端到端空间音频语言大模型,双分支编码器 | 通用全模态音频视觉一体化大模型 |
| 核心亮点 | Apache2.0 开源,原生双耳空间感知,可识别声源方位、距离、运动轨迹,兼顾通用音频理解,适配人车家场景 | 支持音视频 + 文本多模态,音频语义识别强,多语种能力优秀,侧重通用多模态交互,原生无专项空间声源定位模块 |
| 适用场景 | 智能座舱、智能家居、空间音频感知、声源定位开发 | 通用音视频理解、多模态对话、多媒体内容分析 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...