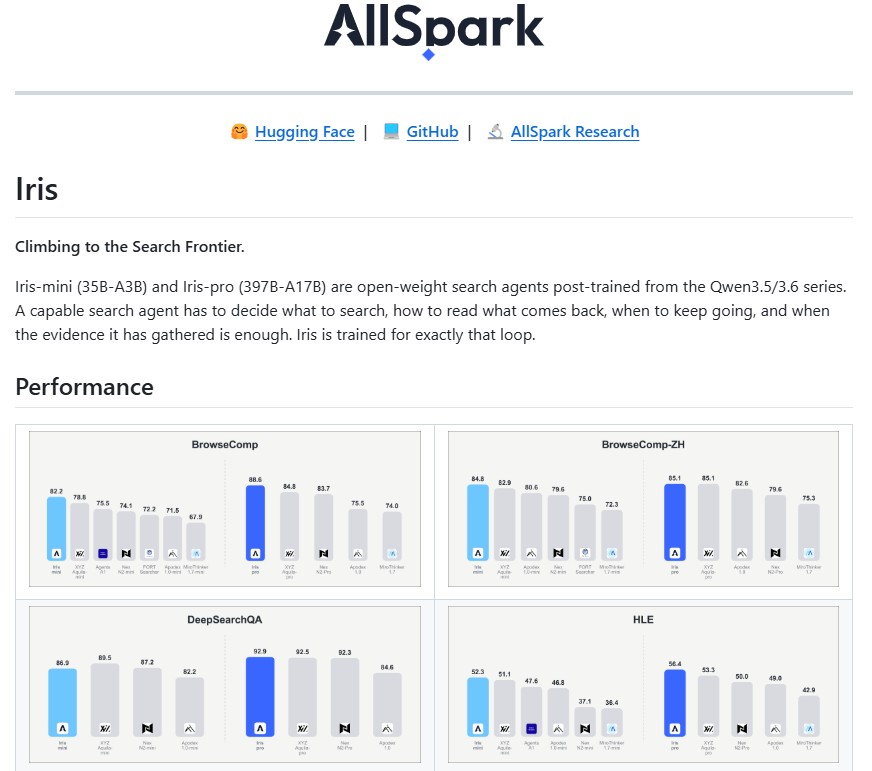
Iris 是小红书 AllSpark 团队开源的搜索智能体(Search Agent),包含 Iris-mini(35B)与 Iris-pro(397B)两个版本,基于通义千问 MoE 基座开发,代码与模型权重托管在 GitHub 仓库。模型收到用户问题后,自主完成检索规划、网页读取、多源信息交叉核验,循环执行搜索动作直到收集足够证据再输出结论,256K 超长上下文窗口支持一次性载入大量网页内容。整套项目附带评测框架 Iris-Harness,采用 Apache2.0 协议开放,科研团队与开发者可本地部署、微调,在 BrowseComp 等搜索基准评测取得优秀成绩。
Iris特点
采用网页超链接图谱反向生成训练数据集,题目设计规避简单字符串匹配,迫使模型完成多页面跨源推理。
训练流程采用 SFT-RL Climbing 方案,监督微调与真实网页环境强化学习交替迭代,提升搜索决策能力。
内置上下文管理机制,在长搜索任务中清理冗余内容,保留关键证据,释放上下文空间继续检索。
双版本差异化设计,Iris-mini 硬件门槛更低,Iris-pro 面向复杂深度调研任务。
原生支持中文搜索评测,在 BrowseComp-ZH 中文基准保持高分表现。
完整开源方案,权重、推理代码、评测脚本对外释放,支持二次开发与模型迭代。
Iris技术原理
Iris 依托 Qwen 系列 MoE 混合专家基座,接收用户查询后,内部生成搜索动作,调用搜索接口获取网页摘要,再读取网页原文提取事实信息。
训练数据从网页超链接网络构建实体关系图,自动生成需要多页交叉验证的问题,过滤掉仅靠字面匹配就能答对的样本。
SFT 阶段使用教师模型在真实搜索环境生成完整搜索轨迹,对轨迹做有效性过滤,再进入强化学习阶段。
上下文管理模块执行 discard-all 策略,上下文达到阈值时清理冗余搜索记录,只保留核心结论,持续维持检索循环。
Iris-Harness 评测框架封装整套搜索仿真环境,自动评估模型的搜索策略、信息提取与答案生成质量。
Iris项目地址
- GitHub仓库:https://github.com/AllSpark-Research/Iris
- HuggingFace模型库:https://huggingface.co/collections/AllSpark-Research/iris
Iris功能
自主联网多步检索
拆解复杂问题,自动生成搜索词,多次调用搜索工具,跨网页收集信息。
多源事实交叉校验
对比不同网页内容,识别信息冲突,筛选可靠资料,减少单源信息带来的偏差。
长文本网页阅读
读取长网页正文,提取关键事实,大容量上下文容纳多篇网页素材。
搜索任务评测
配套 Iris-Harness 工具,在标准基准上复现搜索评测,量化模型搜索能力。
模型微调与二次开发
基于开源权重,在自有搜索数据集上继续训练,适配行业调研场景。
调研报告生成
汇总检索到的多条资料,整理结构化报告,标注信息来源。
Iris应用场景
AI 科研团队
开展搜索智能体相关实验,复现搜索基准测试,研究 Agent 工具调用策略。
行业调研人员
执行竞品分析、行业趋势调研,跨网站收集资料,整理调研文档。
企业研发团队
搭建私有化搜索助手,对接内部检索服务,构建企业知识库检索 Agent。
高校实验室
用于大模型工具使用、联网推理方向课题研究,完成模型训练与对照实验。
开发者
基于 Iris 代码底座,开发面向垂直领域的联网问答产品。
Iris使用教程
克隆 GitHub 仓库`https://github.com/AllSpark-Research/Iris`,按照环境依赖文档安装 Python、SGLang 等组件。
下载对应版本模型权重,准备支持大模型推理的 GPU 硬件,Iris-mini 可在单机多卡环境运行,Iris-pro 需要多机分布式集群。
配置搜索后端接口,接入搜索引擎 API,在配置文件中修改 API 地址与密钥。
编写查询指令,启动推理脚本,模型会自主执行搜索、网页解析、信息汇总。
开启 Iris-Harness 评测脚本,加载基准数据集,自动执行评测并输出指标。
根据业务需求修改提示词模板,调整搜索最大轮次、上下文管理策略。
训练场景准备自定义数据集,使用项目提供的 SFT 或 RL 训练脚本,完成模型微调。
日志文件保存每一轮搜索动作,可查看模型检索路径,定位推理与检索异常。
Iris同类产品对比
表格
| 对比项 | Iris(小红书 Search Agent) | Kimi K2.8 Preview |
|---|---|---|
| 研发主体 | 小红书 AllSpark 团队 | 月之暗面 Moonshot AI |
| 产品定位 | 面向网页浏览、多跳检索的开源搜索智能体模型 | 支持超长上下文的搜索增强大模型 |
| 核心特色 | 35B 轻量参数,SFT-RL Climbing 训练策略,网页超链接构造训练数据,BrowseComp 基准表现优秀,开源可部署 | 200 万 token 超长上下文,内置联网检索,长文档深度理解,开箱即用 API,侧重长资料精读 |
| 适用场景 | 网页多步骤信息检索、开源 Search Agent 二次开发、复杂网页推理任务 | 长文档阅读、海量资料综合问答、企业知识库检索 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...