
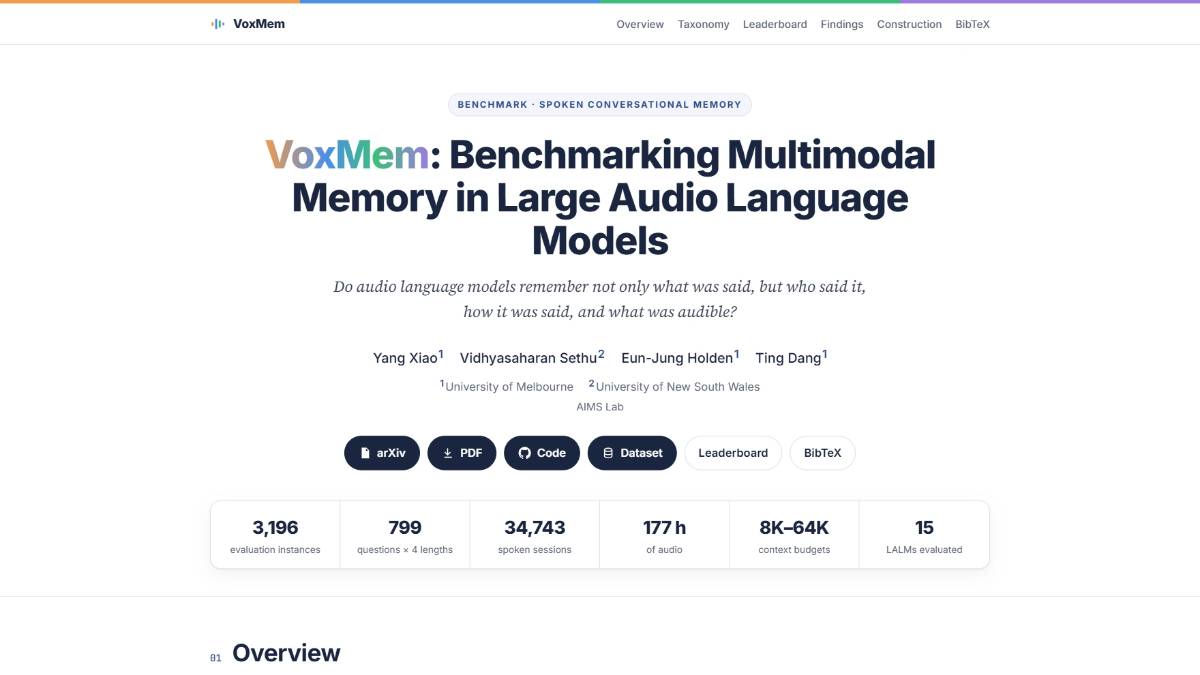
VoxMem是专门针对音频大语言模型构建的多会话记忆评测基准,数据集合计 177 小时音频素材,包含 34743 条语音会话,3196 组评测实例。这套基准不只检验文本转写后的文字内容记忆,还把说话人身份、副语言语调特征、环境背景声纳入考察范围,设置 8K 至 64K 多档上下文窗口,覆盖跨会话推理、时序状态追踪、信息提取、拒绝作答四类测试任务。测试过程必须输入原始音频,仅依靠文本转录无法完成全部项目的校验,网页站点公开排行榜、数据集下载入口与完整运行代码。
VoxMem特点
评测覆盖音频原生信号,部分测试项目无法依靠纯文本转录完成。
样本构建多会话历史,加入干扰会话片段,规避关键词匹配带来的虚高得分。
设置四档上下文窗口,记录不同长度下模型性能衰减变化。
划分四类声学证据与四类记忆任务,输出分项细分测试结果。
公开排行榜记录多款开源与闭源音频模型实测得分。
配套完整开源脚本,本地环境可复现整套评测流程。
VoxMem功能
完成音频大模型语音记忆能力量化打分。
检验模型对说话人身份、语气情绪、环境背景声的留存效果。
开展跨会话信息整合、时序状态追踪类任务校验。
识别模型在证据缺失场景下的拒绝作答表现。
定位模型在长音频任务上的具体失效类型。
输出标准化结果,支持不同模型、不同版本之间横向对比。
VoxMem项目地址
- 项目官网:https://swagshaw.github.io/voxmem/
- GitHub仓库:https://github.com/swagshaw/voxmem
- HuggingFace模型库:https://huggingface.co/datasets/AudioMemory/voxmembench
VoxMem应用场景
音频大模型迭代测试,版本更新后做记忆能力校验。
学术实验,研究长语音场景记忆衰减现象。
模型选型阶段,对比多款音频模型的真实会话表现。
自动化测试流水线开发,集成到模型研发流程。
数据集研究,用于语音记忆相关方向的实验对照。
VoxMem如何使用
访问 Hugging Face Hub 获取 VoxMem 完整数据集,安装项目依赖包。
选定上下文窗口档位,配置待测试音频模型调用参数。
执行运行脚本,依次送入评测会话样本,记录模型输出内容,导出预测文件。
调用打分脚本,选择对应的评判模式,生成各项指标的结果文件。
拆分不同声学证据、记忆任务分组,读取分项测试数据。
对照网页公开排行榜,完成模型能力对比,整理测试报告。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...