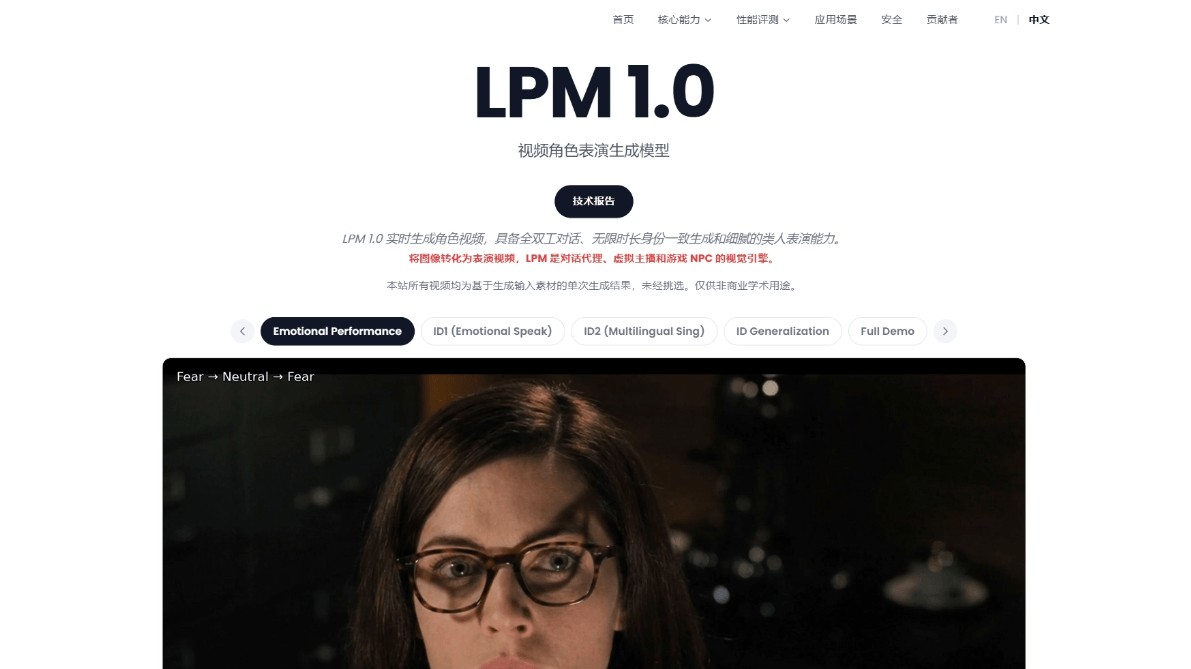
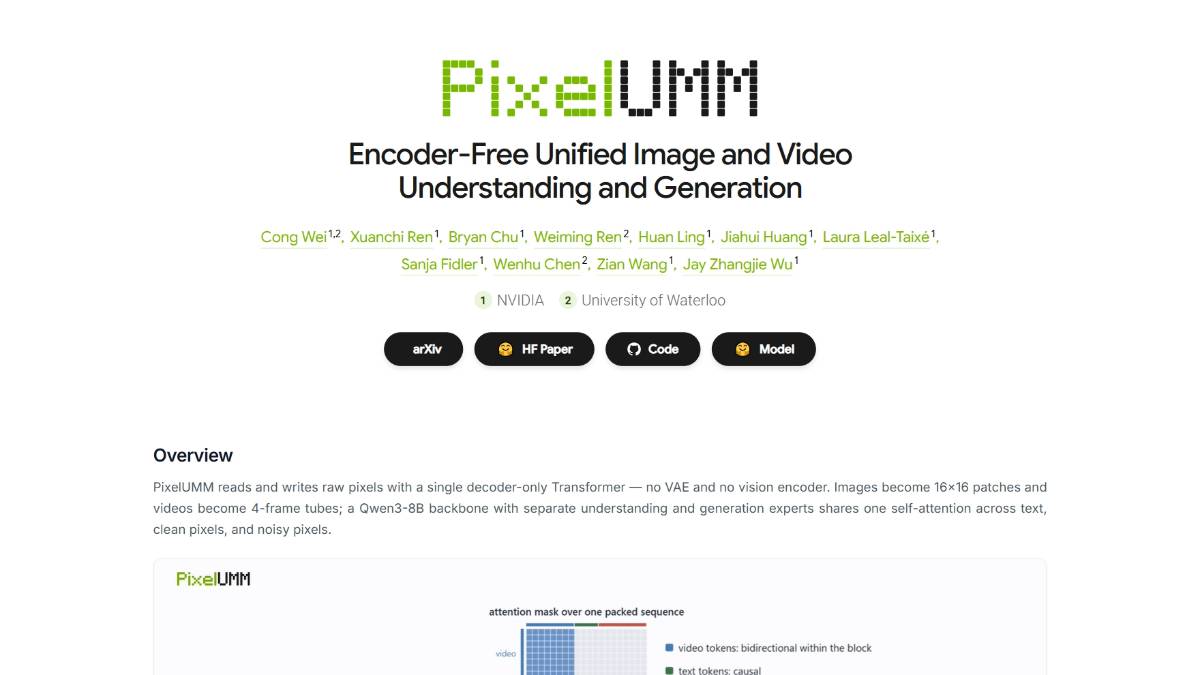
PixelUMM 是 NVIDIA 与滑铁卢大学联合推出的无编码器多模态模型,摒弃传统 VAE 与独立视觉编码器,依靠单一解码器 Transformer 直接读写原始像素。图像拆分为 16×16 补丁,视频拆分为 4 帧时空块,经由单层线性投影送入 Qwen3‑8B 主干网络。模型设置理解、生成两套专家模块,共享自注意力层,同时完成图文问答、图像生成、视频生成、图生视频、视频编辑多项任务,配套完整开源代码、权重与多组对照实验数据,面向视觉多模态算法研究人员开放。
PixelUMM特点
去除 VAE 与独立视觉编码器,原始像素直接参与模型运算,减少中间 latent 转换环节。
理解专家与生成专家共用自注意力机制,兼顾视觉解析与像素生成两类任务。
支持图像、视频、文本交错输入,实现图生视频、视频编辑等复杂任务。
提供线性输出头与多种卷积输出头,卷积头可缓解补丁伪影问题。
提供 sparse、dense 两种视频解析模式,适配不同视频理解场景。
完整放出实验消融数据,记录补丁尺寸、模型规模、算力配置带来的效果变化。
PixelUMM技术原理
主干网络基于 Qwen3‑8B 改造,采用 MoT 混合 Transformer 架构,拆分理解、生成两套前馈专家,自注意力模块全程共享。图像被切分为 16×16 像素补丁,视频被切分为 16×16×4 时空块,原始 RGB 像素经过单层线性投影转换为模型 token。干净参考素材送入理解专家,含噪声目标像素送入生成专家,在共享自注意力层完成多模态信息交互。线性或者卷积输出头把隐藏特征还原为 RGB 像素。训练采用多任务微调策略,覆盖图像理解、视频理解、图生图、文生图、文生视频、图生视频、视频编辑任务。同时设置 sparse 与 dense 两种视频采样接口,分别按 1FPS、4FPS 抽取帧做输入处理。
PixelUMM项目地址
- 项目官网:https://nv-tlabs.github.io/PixelUMM/
- GitHub仓库:https://github.com/nv-tlabs/PixelUMM
PixelUMM功能
图像理解,接收图片与文本提问,输出图片内容对应的文本回答。
视频理解,读取长短视频素材,完成时序事件解析、细节问答。
文生图像,输入文本描述输出原始像素图像结果。
文生视频,接收文本提示生成连续视频片段。
图生视频,上传参考首帧图像,生成延续画面运动的视频。
视频编辑,输入原始视频与修改指令,输出改动后的视频片段。
多组消融实验测算,评估补丁大小、输出头、参数量、算力规模对效果的影响。
PixelUMM应用场景
多模态算法研究,用于无编码器像素级多模态方向的实验对照。
图像视频统一模型原型开发,参考架构设计新的视觉生成方案。
学术评测工作,在图像、视频多组公开基准上开展模型性能比对。
AIGC 内容原型验证,测试像素直接生成链路的画面表现与缺陷。
视觉大模型架构探索,研究去除 VAE 之后多模态模型的能力边界。
PixelUMM使用教程
1. 访问 nv‑tlabs.github.io/PixelUMM/ 项目网页,查阅论文、样例效果与实验图表。
2. 前往代码仓库下载项目源码,从 Hugging Face 获取官方模型权重,配置 GPU 运行环境。
3. 安装项目依赖包,核对主干网络配置文件,选择线性输出头或者卷积输出头。
4. 准备输入素材,文本、图片或者视频,按照项目要求处理输入尺寸。
5. 调用推理脚本,选择图像问答、视频问答、文生图、文生视频等任务模式,运行得到输出结果。
6. 开展消融实验,修改补丁尺寸、输出头类型、采样模式,记录输出质量变化。
7. 接入评测脚本,在图像、视频公开基准上完成量化指标测算。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...