HeyGenVoice 是 HeyGen 面向数字人场景打造的自研语音模型,集成文本转语音与语音克隆能力,覆盖上百种语言及方言。该模型专门针对数字人唇形匹配做优化,输出音频附带精细时间戳,支持短样本声纹复刻,文字输入后生成带自然停顿、情绪变化的人声。模型与平台数字人渲染链路深度整合,音频生成后直接驱动虚拟形象面部动作,省去后期音画对齐操作,支持单段音频生成与批量内容产出,适配多语种数字人视频制作需求。
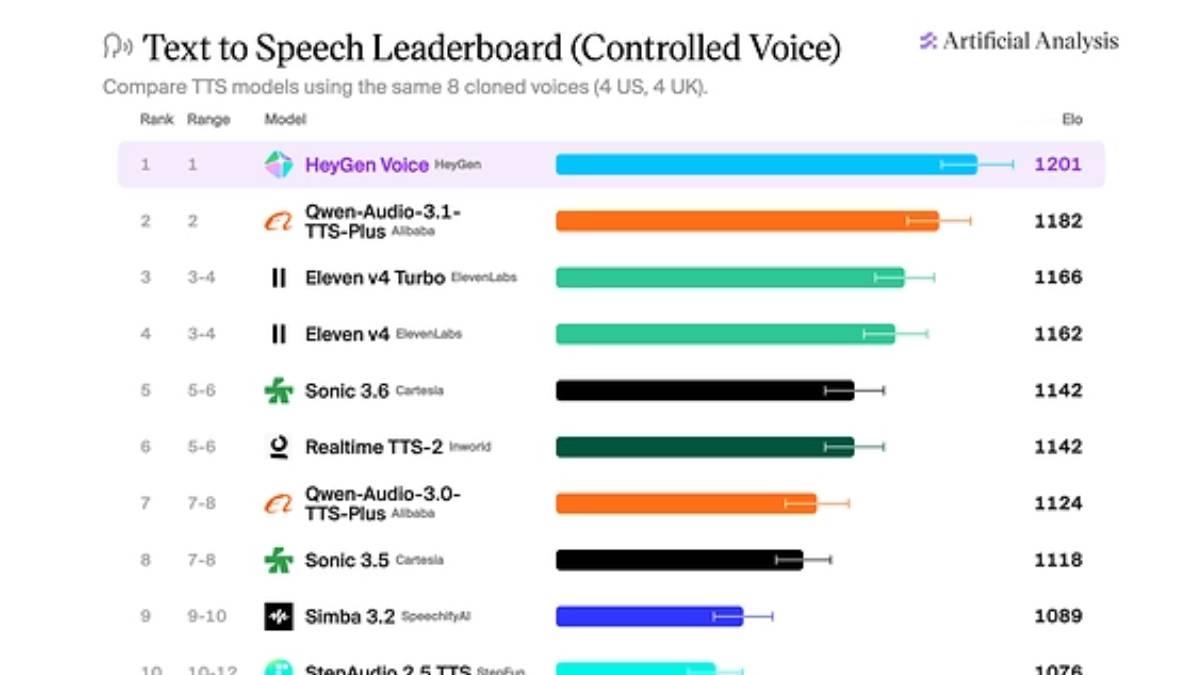
HeyGenVoice特点
模型原生适配数字人渲染管线,音频时序标记可直接用于唇形计算。
短时长人声样本即可完成声线复刻,跨语种生成保留原有声纹特征。
提供多维度音频参数调节,可修改语速、音高与表达情绪。
内置大量基础音色,无需克隆也可直接调用。
支持独立音频导出,生成的音频文件可用于第三方剪辑软件。
开放 API 接入,支持业务侧批量调用语音生成能力。
HeyGenVoice技术原理
基于端到端神经语音架构,从参考人声提取音素、韵律、气息等声学特征,构建专属声线表征。输入文本解析为音素序列,结合目标声线表征生成原始音频波形。模型在训练阶段加入时序对齐任务,输出音频附带逐字时间标记,同步传递给数字人模块,完成唇部运动计算。跨语言模块建立不同语种发音映射,在更换语言时维持声线特征稳定。
HeyGenVoice功能
文本转语音,输入脚本生成高质量人声旁白。
语音克隆,上传干净人声样本复刻专属声线。
多语种语音合成,使用同一克隆声线生成不同语言音频。
音频参数调节,调整语速、音高与情绪表达。
数字人唇形同步,生成音频自动驱动虚拟人物口型。
音频文件导出,单独保存音频素材。
API 批量调用,批量提交文本生成语音。
HeyGenVoice应用场景
跨境短视频制作,快速产出多语言数字人宣传短片。
企业培训视频,制作系列课程的稳定旁白内容。
在线教育课件,打造统一声线的教学讲解音频。
品牌宣传片,固定品牌声线完成多版本内容制作。
交互式数字人项目,提供实时对话语音输出。
自媒体内容生产,降低配音录制的时间成本。
HeyGenVoice使用教程
1. 登录 HeyGen 平台,新建项目进入编辑界面,打开语音设置面板。
2. 选择平台内置音色,或开启语音克隆通道,上传无杂音人声样本。
3. 等待声线模型处理完成,在音色列表选中目标声线。
4. 粘贴文本脚本,调整语速、音高与情绪参数,试听音频预览。
5. 确认音频后绑定数字人形象,系统自动完成唇形匹配。
6. 执行视频渲染,也可单独导出音频文件保存至本地。
7. 大批量内容生产场景,调用平台 API 提交文本任务。
HeyGenVoice同类竞品对比
表格
| 产品 | 研发主体 | 产品定位 | 核心特色 | 适用场景 |
|---|---|---|---|---|
| HeyGenVoice | HeyGen | 面向数字人视频配套的 TTS 与语音克隆工具 | 175 + 语言,一键语音克隆,语音可直接联动 HeyGen 数字人,自动对齐口型 | 营销短视频、企业培训数字人视频、多语种口播内容 |
| ElevenLabs v4 | ElevenLabs | 通用型高品质 TTS & 语音克隆基础音频模型 | 音色表现力强,海量预制音色,支持丰富情绪控制,API 能力完善 | 播客、有声书、音频创作、第三方应用接入音频能力 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...