
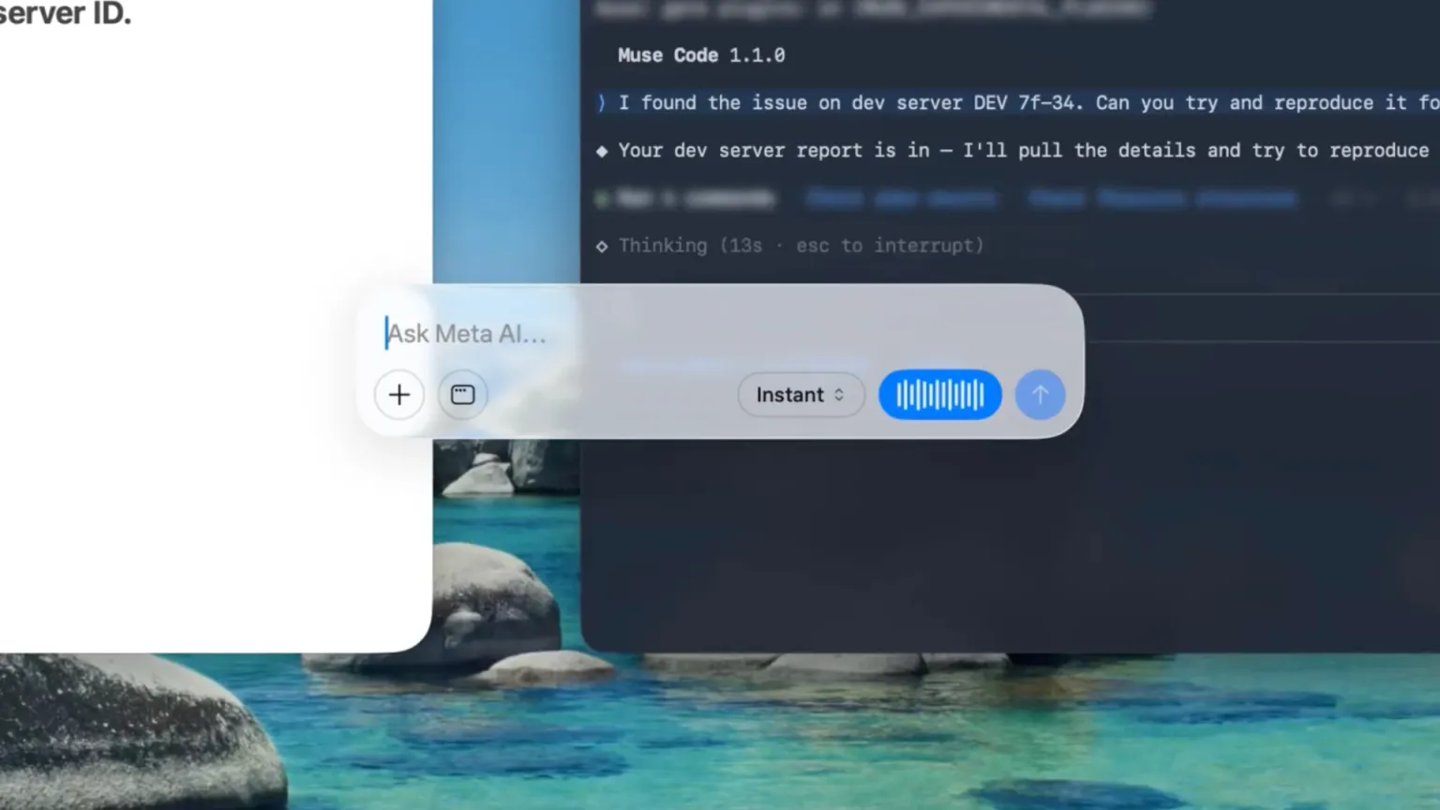
Muse Voice Transcribe – Meta推出的实时音频感知模型
Muse Voice Transcribe 是 Meta Superintelligence Labs 推出的实时音频感知模型,也是 Meta 旗下首款专门面向实时音频场景的模型产品。模型在同一套架构...

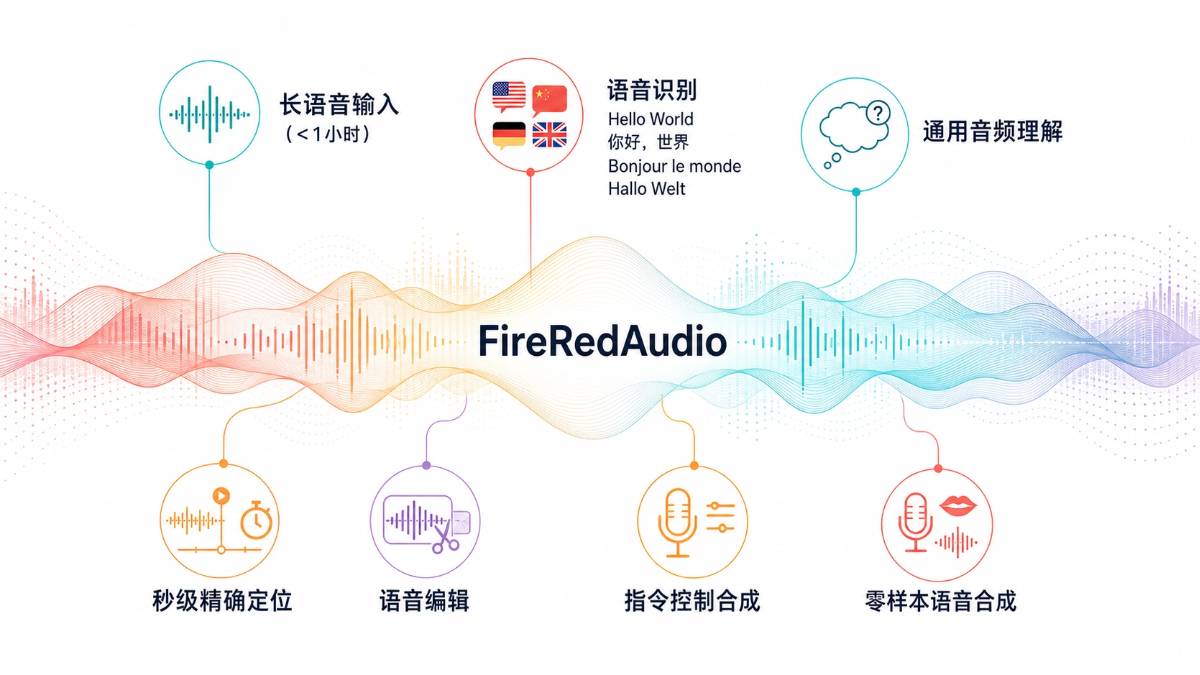
FireRedAudio – 小红书FireRed团队推出的音频模型
FireRedAudio 是小红书 FireRed 团队推出的通用音频语言模型,隶属于 FireRed 模型矩阵,基于 90 亿参数的 Qwen3.5 架构打造,采用解耦连续表征设计,在同一套自回归框...
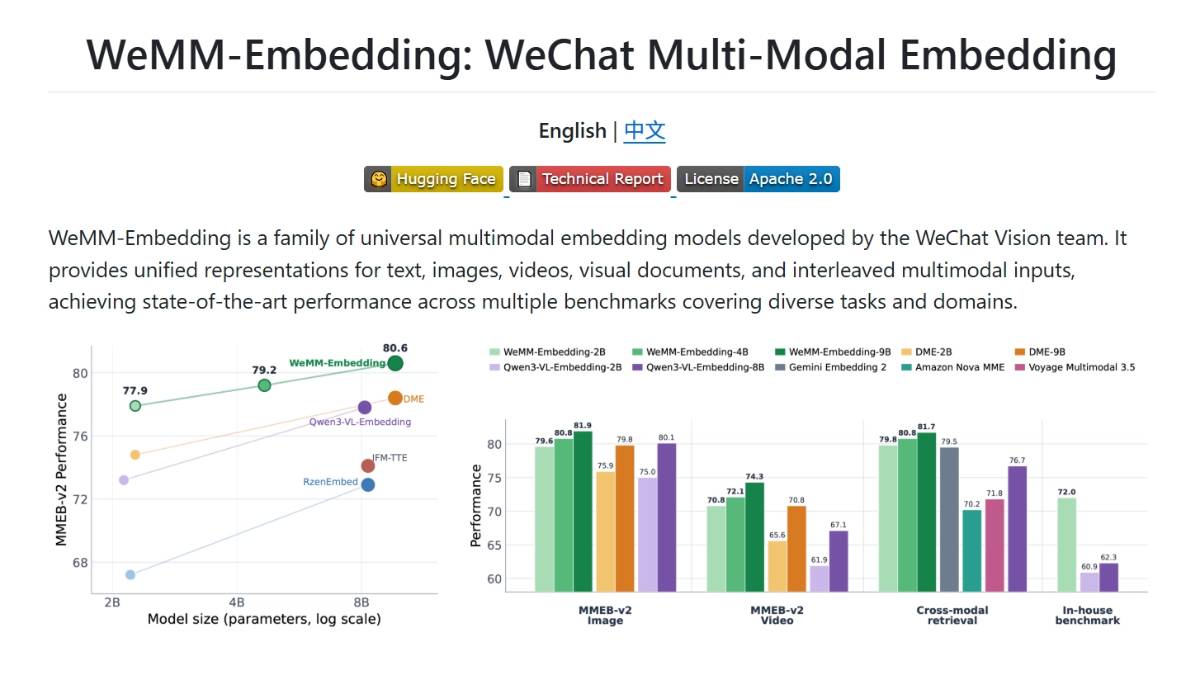
WeMM-Embedding – 腾讯推出的通用多模态嵌入模型家族
WeMM-Embedding 全称 WeChat Multi-Modal Embedding,是腾讯微信视觉团队推出的通用多模态嵌入模型家族,包含 2B、4B、9B 三种参数规格,基于 Qwen3.5...
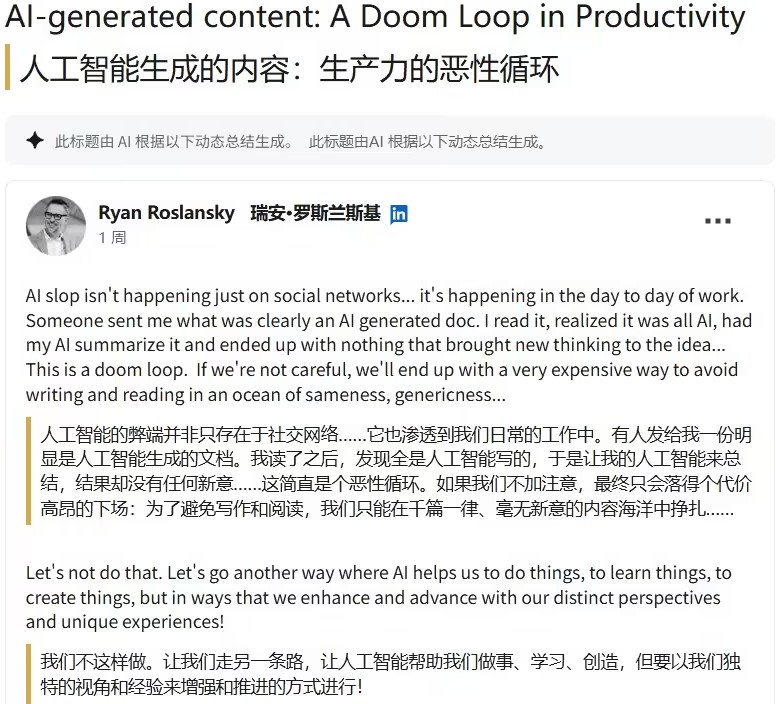
微软高管示警:低质量AI正在稀释办公信息价值
微软执行副总裁、Office 与 LinkedIn 业务负责人瑞安・罗斯兰斯基近日在领英发布动态,指出低质量 AI 生成内容已渗透进日常办公场景,形成 AI 生成、AI 阅读、AI 摘要的恶性循环,信...
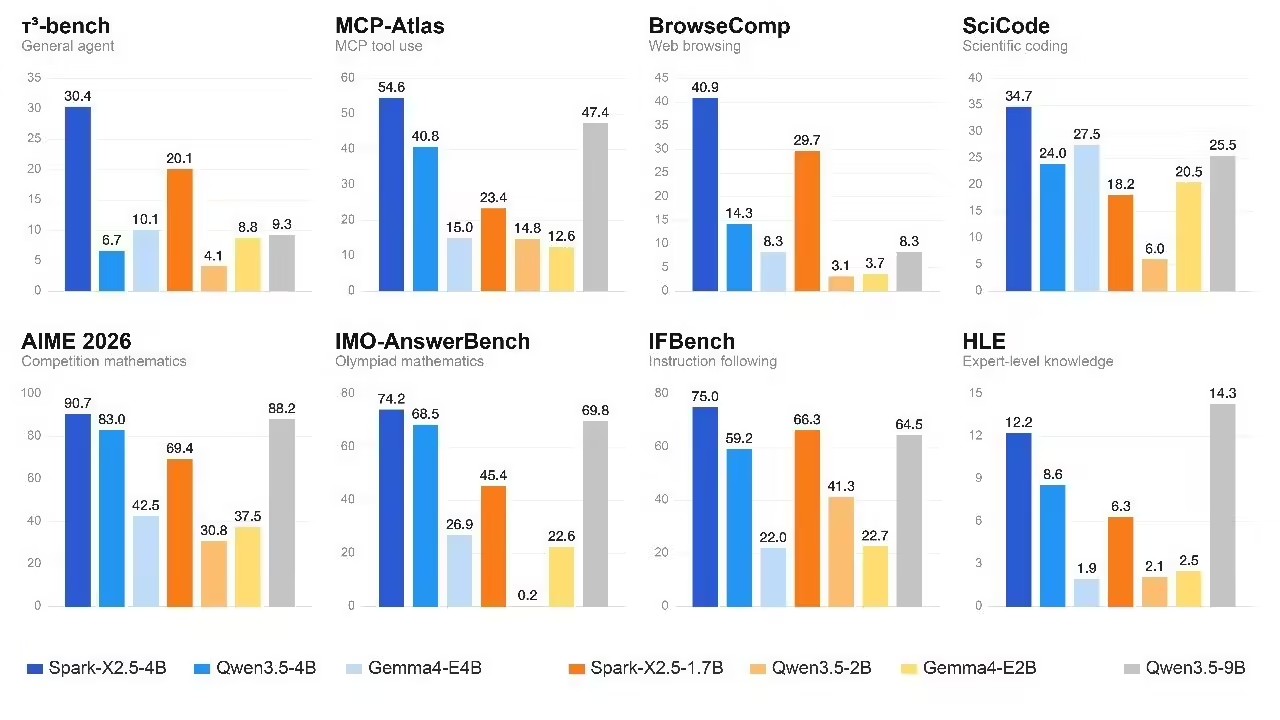
X2.5-4B X2.5-1.7B – 科大讯飞推出的两款端侧通用模型
星火 X2.5-4B 与星火 X2.5-1.7B 是科大讯飞推出的两款端侧通用模型,同步正式发布并开放权重。两款模型同属星火 X2.5 系列,分别对应 40 亿与 17 亿参数规格,原生支持最长 10...
Hy4 preview 轻量版 – 混元基于Hy4 preview模型推出的量化压缩版本
Hy4 preview 轻量版是腾讯混元基于Hy4 preview旗舰模型推出的量化压缩版本,面向低硬件资源部署场景打造。原版 Hy4 preview 为 7700 亿总参数的混合专家模型,原版 BF...
告别大小模型分流,智谱新基座目标上线即承载全量业务
智谱AI对外披露下一代大模型技术路线与交付目标。新模型将采用“大基座”架构,不再区分基础版与轻量版,单一权重同时覆盖从端侧推理到云端高并发的全场景需求;内部验收标准明确要求发布首日即可承接现有全部AP...
Agent支付能力落地,微信支付AI专属卡接入两大开源执行框架
微信支付AI专属卡正式完成对DeepSeek Harness智能体执行框架及OpenClaw开源工具链的接入支持。此次更新后,开发者可通过该卡在合规沙箱环境中直接调用上述两类Agent基础设施,用于构...
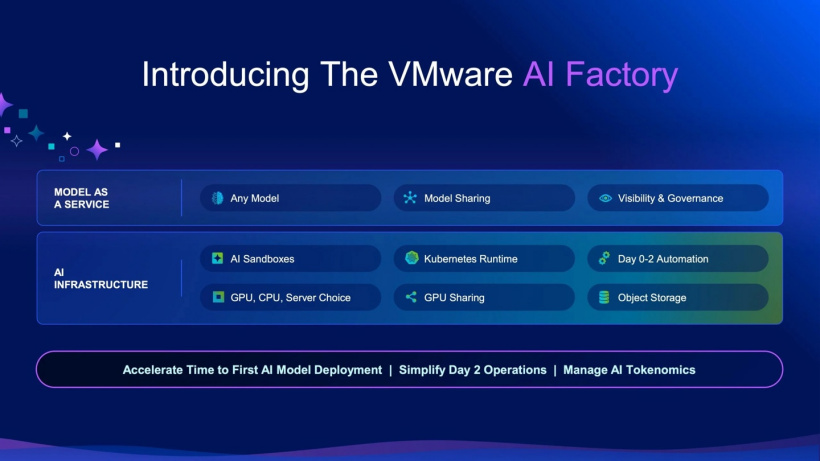
VMware AI工厂 – Broadcom推出的一站式AI基础设施解决方案
VMware AI工厂是Broadcom推出的一站式AI基础设施解决方案,将计算、存储、网络、安全与AI运维整合为统一平台,让企业像运营传统数据中心一样部署和管理AI工作负载。它并非单一产品,而是由V...
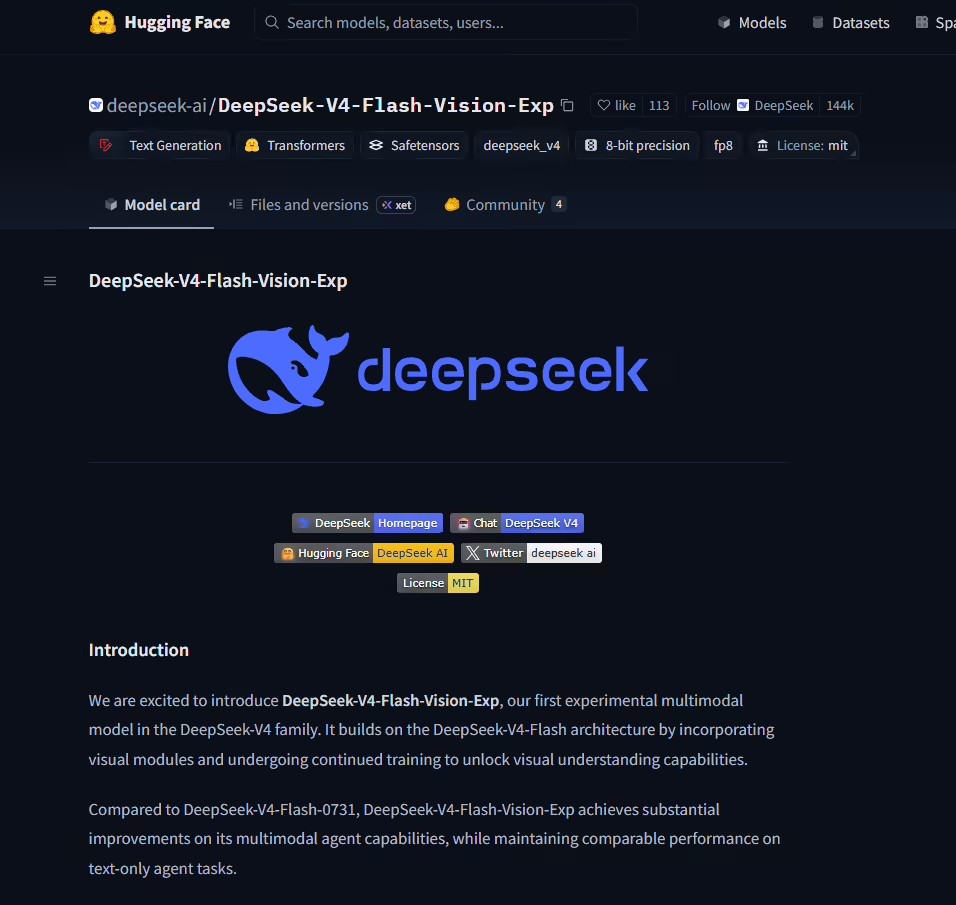
DeepSeek终于能看图了,V4视觉模型MIT协议开源
DeepSeek V4系列首款原生支持图片输入的视觉模型DeepSeek-V4-Flash-Vision-Exp正式以MIT协议在Hugging Face开源,这款此前已于8月21日上线DeepSee...